NVIDIA Green Contexts: Explizite Aufteilung von GPU-Ressourcen für gleichzeitige Aufgaben
 Public
- 07 Oct, 2026
Moderne GPU-Anwendungen führen häufig mehrere unabhängige Komponenten innerhalb eines einzelnen Prozesses aus, beispielsweise Latenz-sensitive Operatoren neben durchsatzorientierten Hintergrundkernels. Diese Komponenten teilen sich oft eine einzelne GPU, was zu unvorhersehbarer gegenseitiger Beeinflussung und Ressourcenkonkurrenz führt. Traditionelle CUDA-Contexts wurden für eine Ära entwickelt, in der GPUs einzelne dominante Workloads bearbeiteten. Dadurch sind sie schwerfällig und eignen sich schlecht für eine feingranulare Ressourcenpartitionierung. Sie verursachen erhebliche Hardware-Overhead bei Kontextwechseln und fehlen Mechanismen, um explizit zu definieren, wie Ausführungsrressourcen zwischen gleichzeitigen Aufgaben aufgeteilt werden.
Green Contexts lösen dieses Problem, indem sie Anwendungen erlauben, ein Teilmenge der GPU-Ausführungsressourcen explizit auszuwählen und Arbeit direkt auf diese Ressourcen zu lenken. Seit CUDA 12.4 im Driver API verfügbar, sind sie ab CUDA 13.1 über das Runtime API zugänglich. Diese Funktion ermöglicht es Entwicklern zu definieren, wo Arbeit ausgeführt wird und wie Ressourcen innerhalb eines Prozesses aufgeteilt werden. Der primäre Anwendungsfall ist die SM-Partitionierung, bei der bestimmte Streaming Multiprocessors einem Green Context zugewiesen werden. Dies ermöglicht es mehreren Workloads, gleichzeitig zu laufen, ohne um dieselben Recheneinheiten zu konkurrieren.
Neben der SM-Zuweisung können Green Contexts Workqueue-Ressourcen bereitstellen. Im traditionellen Modell konnten unabhängige, stromgeordnete Workloads auf dieselben zugrunde liegenden Workqueues gemappt werden, was zu einer unbeabsichtigten Serialisierung führte, selbst wenn ausreichend Ausführungsrressourcen verfügbar waren. Durch die explizite Bereitstellung von Workqueues ermöglichen Green Contexts Anwendungen, die erwartete Parallelität auszudrücken und falsche Abhängigkeiten zu beseitigen. Diese Kontexte sind leichtgewichtig in der Erstellung und Zerstörung, und ihr Lebenszyklus synchronisiert nicht implizit nicht zusammenhängende GPU-Arbeit, was ein expliziteres Programmiermodell bietet als die Verlässlichkeit auf den impliziten Gerätezustand.
Das Programmiermodell verschiebt sich von impliziter zu expliziter Zielzuweisung. Historisch nutzten Anwendungen cudaSetDevice() und erstellten Ströme, deren Ausführungsziel aus dem aktuellen thread-lokalen Gerätezustand abgeleitet wurde. Mit Green Contexts, dargestellt durch den Typ cudaExecutionContext_t, erstellen Entwickler einen Kontext für eine gewählte Ressourcenmenge und erstellen daraus Ströme mithilfe von cudaExecutionCtxStreamCreate(). Dies stellt sicher, dass die in diese Ströme eingereichte Arbeit streng mit den Ressourcen des Green Context verknüpft ist. Für Anwendungen, die das gesamte Gerät als Ziel haben, bleibt das traditionelle Modell über cudaDeviceGetExecutionCtx() verfügbar, was die Rückwärtskompatibilität und eine schrittweise Einführung gewährleistet.
Ein kanonischer Anwendungsfall ist das Überlappen von Kommunikation mit GEMM-Kernels im verteilten Training oder die Handhabung latenzsensitiver Operatoren auf KI-Sensorplattformen. Die Stream-Priorität allein ist unzureichend, wenn Bulk-Kernels alle SMs belegen, da der Scheduler ausführende Blöcke nicht vorzeitig beenden kann. Green Contexts widmen bestimmte SMs der kritischen Arbeit und umgehen das Warten auf das Abklingen der Bulk-Blöcke. Tests auf einer NVIDIA Blackwell GPU mit 148 SMs zeigten, dass die Stream-Priorität eine 27-fache Verbesserung gegenüber Strömen gleicher Priorität bietet, während Green Contexts durch die Sicherstellung dedizierter Ressourcen für den kritischen Kernel eine zusätzliche Latenzreduzierung um den Faktor 20 ermöglichen.
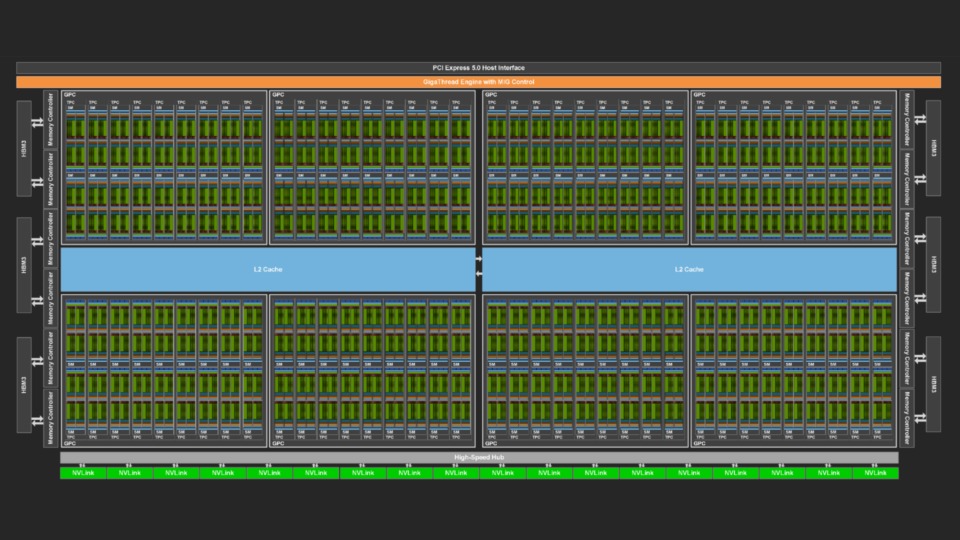
Die Implementierung umfasst das Abfragen der Geräteressourcen, das Aufteilen der SMs in kritische und verbleibende Gruppen sowie das Packen jeder Gruppe mit spezifischen Workqueue-Konfigurationen. Entwickler verwenden cudaDevSmResourceSplit zum Ausschneiden von Ressourcen und cudaDevResourceGenerateDesc zum Erstellen von Deskriptoren. Green Contexts sind optional und ergänzend, sodass bestehende Anwendungen weiterhin das gesamte Gerät nutzen können, während sie bei Bedarf eine feinere Kontrolle übernehmen. Dieser Ansatz ist besonders nützlich, um gewünschte Parallelitäts- oder Latenzziele in komplexen Workflows zu erreichen, und bietet einen robusten Mechanismus zur Verwaltung der GPU-Ressourcenfreigabe in modernen, mehrkomponentigen Anwendungen.