NVIDIA AICR bestätigt die Kubernetes-Unterstützung für Vera Rubin NVL72
 Public
- 03 Nov, 2026
Die Konfiguration von Kubernetes für neue GPU-Hardware wie NVIDIA Vera Rubin ist komplex und fehleranfällig und erfordert eine präzise Abstimmung von Treibern, Kernels, Runtimes und Scheduling-Systemen. Der NVIDIA AI Cluster Runtime (AICR), ein Bestandteil der DSX AI Factory Platform, vereinfacht diesen Prozess, indem er optimierte Konfigurationen in wiederverwendbaren Rezepten festhält. Er generiert Bundles für Deployment-Tools und validiert laufende Cluster, um sicherzustellen, dass die Umgebungen ab Tag 1 für die Compute-Trays von Vera Rubin NVL72 bereit sind. Dieser Ansatz hilft Plattformteams, effiziente KI-Fabriken mit modularen Open-Source-Softwarekomponenten zu entwerfen, aufzubauen und zu betreiben.
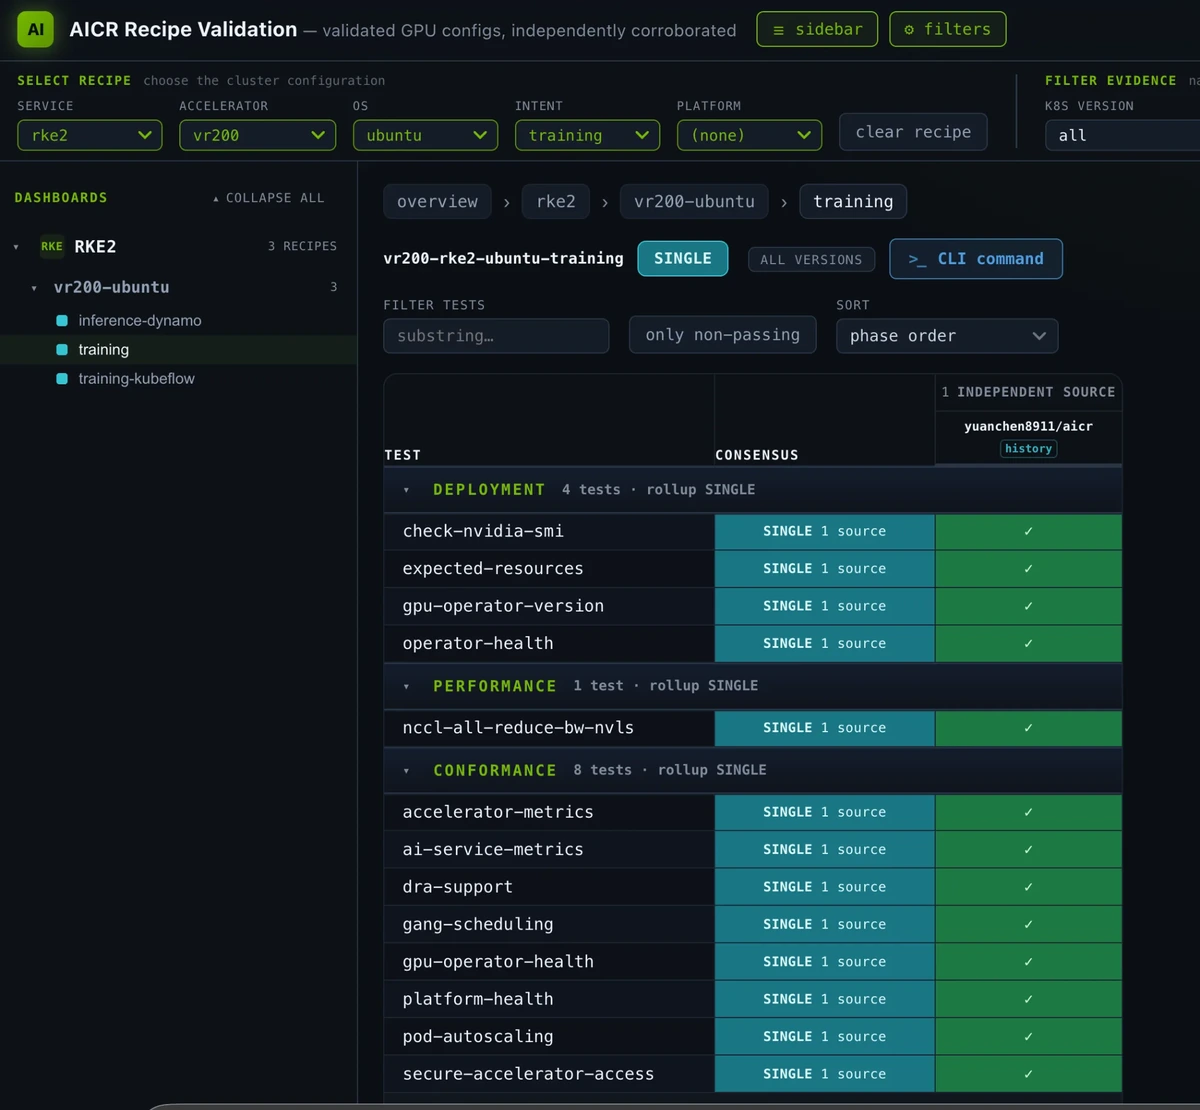
Für Teams, die derzeit GB200 NVL72 betreiben, ist Vera Rubin NVL72 die dritte Generation der MGX-Rack-Architektur mit mehreren nutzerseitig sichtbaren Änderungen. Um die Unterstützung von Anfang bis Ende zu validieren, wurde das AICR-Runtime-Bundle auf Vera-Rubin-Clustern mit GPU Operator v26.7.0, DRA-Treiber v0.5.0 und einem auf dem Host installierten R615-Treiber deployed. Beide Rezeptvarianten, für Training und Inferenz, bestanden die End-to-End-Validierung. Die Trainingsvariante enthält eine Leistungsschwelle: einen Cross-Node-NCCL-All-Reduce über das NVLink-Gewebe über ein IMEX-ComputeDomain, begrenzt durch einen Mindestwert der Busbandbreite. In der frühen Validierungsphase trat ein vorübergehendes Hardware- oder Gewebe-Problem in einem Cluster auf, das jedoch durch das erneute Einsetzen der Hardware gelöst wurde, sodass alle GPUs einem einzigen Fabric-Clique beitreten konnten.
AICR erfasst plattformspezifische Entscheidungen als versioniertes Rezept und macht Konfigurationen damit explizit und reproduzierbar. Die neue Rezeptfamilie für Vera Rubin (Service: rke2, Accelerator: vr200, OS: Ubuntu) wird als Preview ausgeliefert und verfügt über keine vollständige Produktionsunterstützung, solange die Plattform im Pre-Release-Stadium ist. Die erste Bereitstellung zielte auf eine neuartige Kombination ab: arm64, Ubuntu 26.04, ein Kernel mit 64k-Seitengröße, RKE2 und Vera Rubin, was zu einem funktionsfähigen Runtime in wenigen Stunden führte. Ein zweiter Cluster reproduzierte dieses Ergebnis am nächsten Tag und demonstrierte die Wiederholbarkeit des Rezepts. Dieser versionierte Ansatz stellt sicher, dass die spezifischen Entscheidungen, die während des Bring-up-Prozesses getroffen wurden, erhalten bleiben und auf verschiedenen Clustern überprüfbar sind.
Der AICR-Workflow, ausgeführt mit der v1.0.0-Toolchain, beginnt mit der Offline-Generierung des Rezepts. Der Befehl aicr recipe löst Kriterien anhand des Katalogs auf und erzeugt eine YAML-Datei, die fünf Overlays auf 14 Komponenten auflegt. Zu den wichtigsten Komponenten gehören GPU Operator, DRA-Treiber, DraNet für die Zuweisung von ConnectX-9-Geräten und NodeWright für den exklusiven RDMA-netns-Modus. Der Befehl zur Paketgenerierung aicr bundle erstellt eine Reihe geordneter Helm-Charts und ein Deployment-Skript. Dieses Paket enthält NodeWright, KAI Scheduler, NVSentinel, NFD und den Prometheus-Stack, wobei die Versionen aller Komponenten an die auf Vera-Rubin-Hardware validierte Konfiguration festgelegt sind.
Die Validierung umfasst das Erfassen des Cluster-Zustands und die Prüfung der Readiness-Bedingungen. Der Befehl aicr snapshot speichert den Zustand, während aicr validate die Phasen für Deployment, Konformität und Leistungsfähigkeit ausführt. Die Deployment-Phase prüft die OS-Version und Kernel-Details, während die Konformitätsphase den Gesundheitszustand der Komponenten verifiziert. Die Leistungsphase führt ein NCCL all-reduce als In-Cluster-Job aus und prüft die Busbandbreite anhand des Mindestwerts aus dem Rezept. Der Validator provisioniert ComputeDomain und IMEX ResourceClaimTemplate selbst, ohne dass Voraussetzungen seitens des Operators erforderlich sind. Die Inferenzvariante, die die Dynamo-Plattform nutzt, besteht dieselben Deployment- und Konformitätsprüfungen auf dem identischen Cluster.
Ein kritischer End-to-End-Test umfasst einen ComputeDomain mit zwei Knoten, in dem IMEX-Kanäle von Pods auf jedem Compute-Tray beansprucht werden. Für Images mit host-verwaltetem IMEX muss der statische nvidia-imex-Dienst auf dem Host deaktiviert und maskiert werden, da er mit DRA-verwalteten ComputeDomains inkompatibel ist. GPU Operator v26.7.0 und höher wird mit einem strengeren CRD ausgeliefert, das die explizite Festlegung von numNodeserfordert, was neue Clusterinstallationen betrifft, aber keine Upgrades. Das Anwenden des Testmanifests führt zu zwei laufenden Pods, in die jeweils ein IMEX-Kanal injiziert wird, was etwa 12 Sekunden dauert. Der gesamte Ablauf von der Rezeptgenerierung bis zur Validierung dauert ungefähr fünf Minuten, wobei die Leistungsphase die Laufzeit des NCCL-Jobs hinzuzählt.