Daviator beschleunigt VASP auf NVIDIA-GPUs: gebündelte Berechnung von k-Punkten und gemischte Genauigkeit
 Public
- 18 Nov, 2026
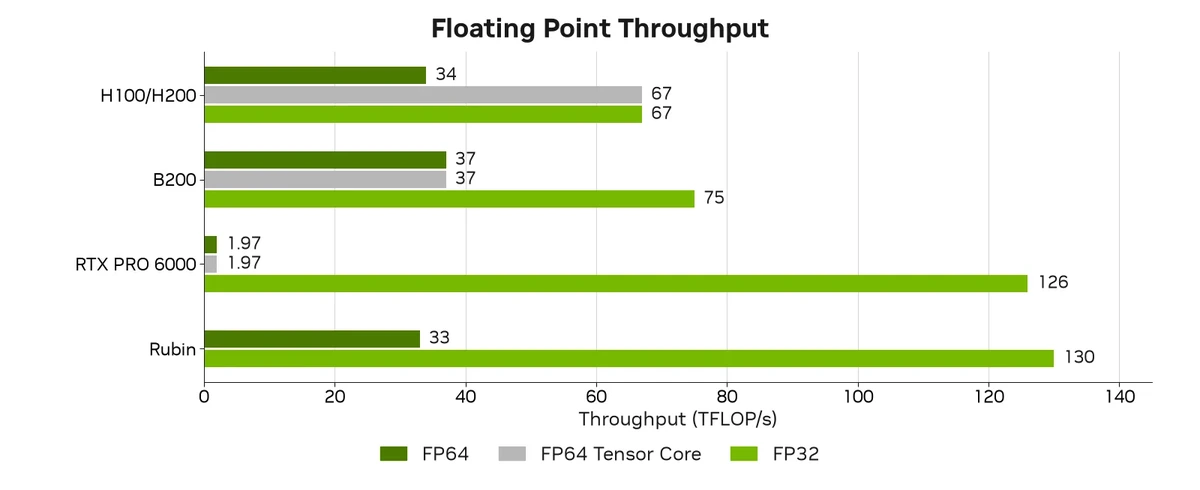
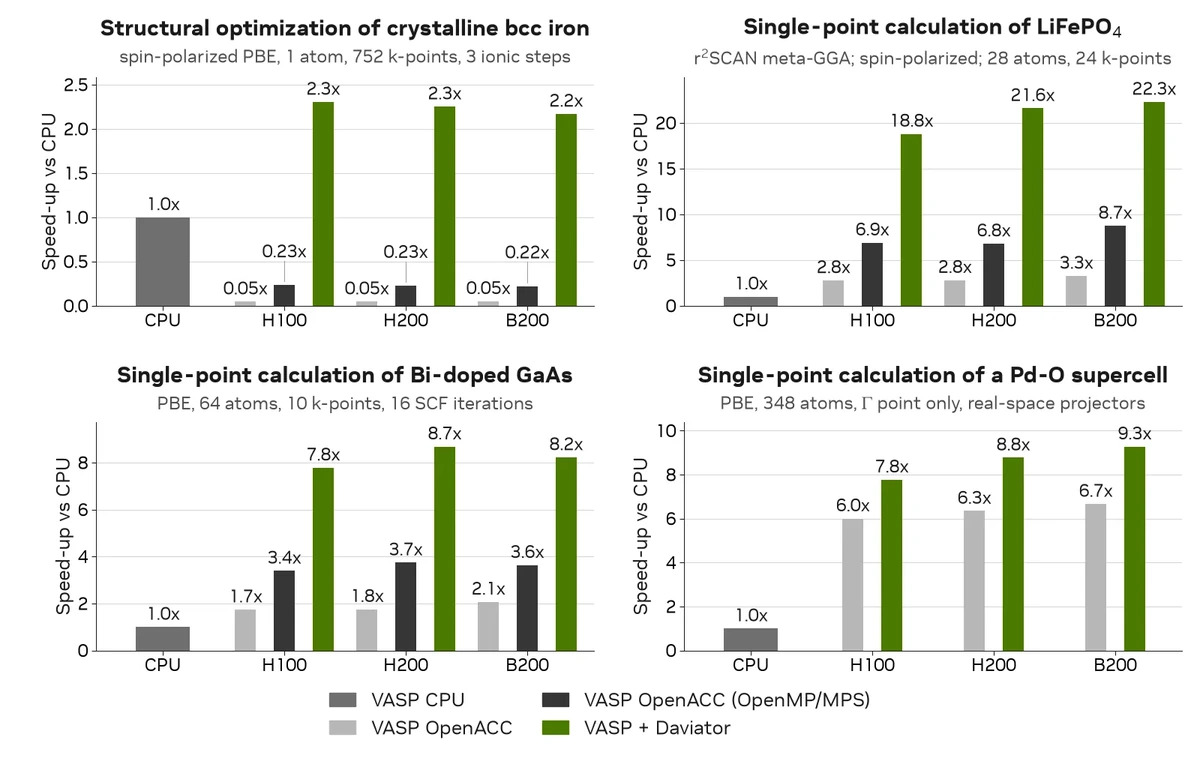
Um maschinell gelernte interatomare Potenziale (MLIPs) zu trainieren, sind zig bis Hunderte Millionen DFT-Berechnungen von Energien, Kräften und Spannungen nötig. Meist werden sie mit VASP erzeugt, dem führenden Ebene-Wellen-DFT-Code. Solche Aufgaben verwenden in der Regel kleine Einheitszellen und dichte k-Punkt-Gitter, wodurch die GPUs nicht ausgelastet werden. Die OpenACC-Portierung von VASP verarbeitet k-Punkte nacheinander, daher werden bei kleinen Systemen pro Schritt Hunderte winziger Kernel gestartet, und der Startaufwand dominiert die gesamte Laufzeit. Ein System aus einem einzigen Eisenatom mit 752 k-Punkten lief auf der GPU 8-mal langsamer als auf der CPU, sodass Forschende Jobs manuell nach Größe verteilen mussten. Hinzu kommt, dass FP64 stagniert: Der FP64-Durchsatz bleibt bei Hopper, Blackwell und Rubin konstant, während FP32 weiter zulegt. Die RTX PRO 6000 hat sogar ein FP32:FP64-Verhältnis von 64:1.
Daviator ist eine NVIDIA-Bibliothek von GPU-Kernels, die Schleifen über k-Punkte durch gebündelte Operationen ersetzt. Im Kern steht ein gebündelter Davidson-Eigenlöser auf Basis gebündelter FFTs, GEMMs und eigener Kernels. Es gibt weniger Kernel-Starts, die SM-Auslastung nähert sich der Sättigung, und die Daten verlassen den GPU-Speicher nicht. VASP behält die SCF-Schleife, das Mixing, die Symmetrie und die Ein-/Ausgabe, während Daviator an klar definierten Aufrufgrenzen eingebunden wird. Aktiviert wird es über den NVIDIA ALCHEMI VASP Microservice mit dem Parameter LDAVIATOR=True in der INCAR, und es übernimmt den Davidson-Löser (ALGO = Normal). Bestehende Eingabedateien müssen nicht geändert werden. Im Beispiel wird ein einzelnes Fe-Atom mit ISPIN = 2, NBANDS = 12, PREC = Accurate und einem Gamma-zentrierten 30x30x30-Gitter verwendet.
Einige Kernels sind auf bestimmte Batch-Größen spezialisiert und werden möglicherweise bei der ersten Verwendung kompiliert. Deshalb sollte CUDA_CACHE_PATH in den Job-Skripten auf einen schnellen Speicher wie /tmp/cudacache statt auf $HOME zeigen, und CUDA_CACHE_DISABLE=0 sollte gesetzt werden. Die Rechnungen werden wie gewohnt gestartet, zum Beispiel mit mpirun -np 1 vasp_std. Derzeit wird nur ein einzelner Knoten unterstützt; Multi-Node-Betrieb, vasp_ncl und vasp_gam sind geplant. Zum Vergleich dienten VASP 6.6.0 auf CPU sowie mit OpenACC auf H100/H200 und B200. Ein einzelnes Eisenatom wird mehr als doppelt so schnell berechnet wie auf der CPU. Bei LiFePO4 mit r2SCAN beschleunigt sich der Davidson-Löser um das 22-Fache, und bei Bi-dotiertem GaAs mit 64 Atomen sinkt die Rechenzeit um mehr als 85%. Selbst ein System mit 348 Atomen und einem einzigen k-Punkt wird schneller berechnet, sodass Jobs nicht mehr nach Größe sortiert werden müssen. Hochrechnungen für Datensätze zeigen eine bis zu 22-mal kürzere Zeit bis zum Ergebnis und bis zu 75% niedrigere Kosten im Vergleich zur CPU.
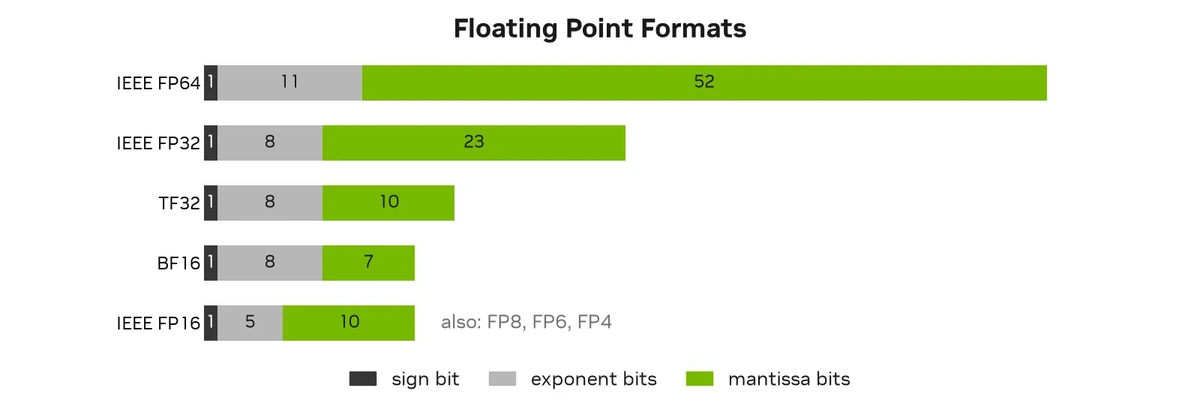
Das gebündelte Daviator rechnet weiterhin in FP64, und einen Davidson-Löser mit gemischter Genauigkeit zu bauen ist schwierig. Wenn man Kernels auf FP32 umstellt und das Ergebnis mit FP64 vergleicht, erfährt man nur „bestanden“ oder „nicht bestanden“. Dabei können verdeckte Fehler, etwa Energiedrift, Konvergenz in die falsche Richtung oder divergierende MD-Trajektorien, durchaus plausibel aussehen. Deshalb wird ein generischer Gleitkommatyp mit konfigurierbarer Anzahl von Mantissen- und Exponentenbits verwendet. Damit wird für jeden Kernel die minimal erforderliche Genauigkeit ermittelt und entschieden, ob er auf FP32 umgestellt, überarbeitet oder als FP64-„Insel“ beibehalten wird. Die Ergebnisse hängen von den Eingabedaten und vom Schwellenwert ab. Die Instrumentierung muss auch Abhängigkeiten und mathematische Funktionen erfassen, und die langsamen instrumentierten Läufe lassen sich auf HPC-Ressourcen parallelisieren. Man beginnt mit FP64↔FP32-Konvertierungen rund um den Hot Path und Kernels mit konfigurierbarem Typ und verkleinert dann von Iteration zu Iteration die FP64-Bereiche.
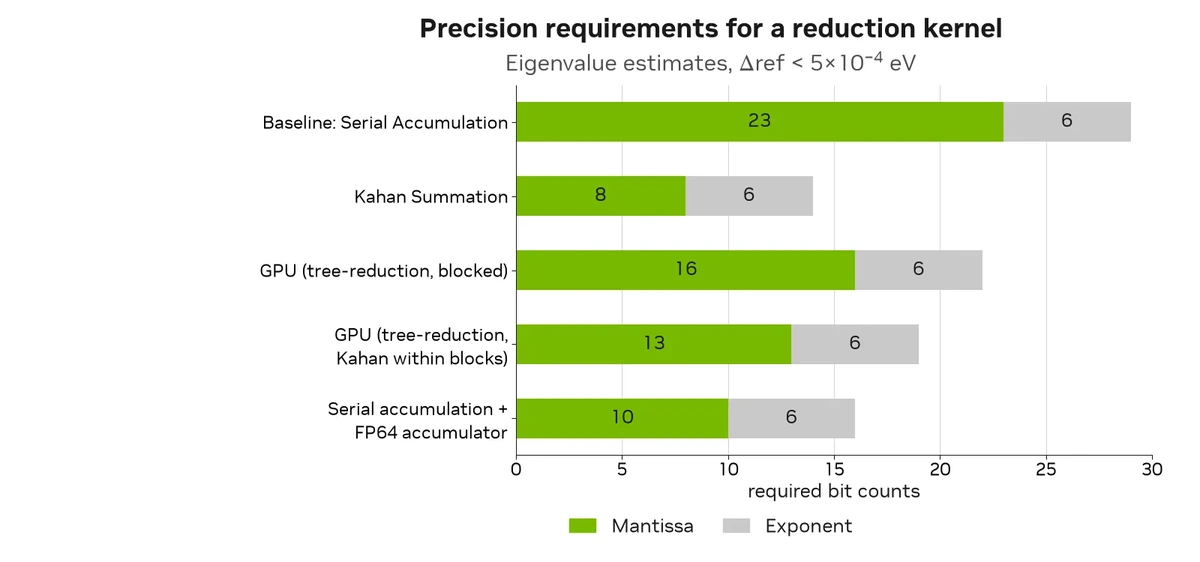
Die Verificarlo-basierte Analyse ergab, dass FFTs, die Anwendung des Hamiltonoperators und die Aktualisierung der Orbitale in FP32 ausgeführt werden können. Das Eigenwertproblem im Unterraum, die Energien, die Konvergenzkriterien und die hohen, schmalen GEMMs, aus denen die Unterraummatrizen aufgebaut werden, blieben in FP64. Diese Rayleigh-Ritz-GEMMs speisen einen empfindlichen Eigenwertlöser, daher kommt ein Split-k-Algorithmus zum Einsatz: Die Skalarprodukte werden blockweise in FP32 berechnet, die abschließende Akkumulation erfolgt in FP64. Der EDIFF-Schwellenwert in VASP liegt standardmäßig bei 10-4 eV und kann auf 10-6 eV oder darunter gesenkt werden, während FP32 etwa 7 signifikante Stellen bietet. Der gemischte Löser konvergiert je nach Eingabe bis 10-4 bis 10-6 eV, unterhalb des FP32-Rauschpegels wird die Rechnung in FP64 fortgesetzt. Bei GaAsBi-64 bringt FP32 bei EDIFF = 10-5 eV eine Beschleunigung um das 2-Fache, und die Kombination FP32→FP64 ist bei 10-8 eV 1,5-mal schneller als reines FP64.
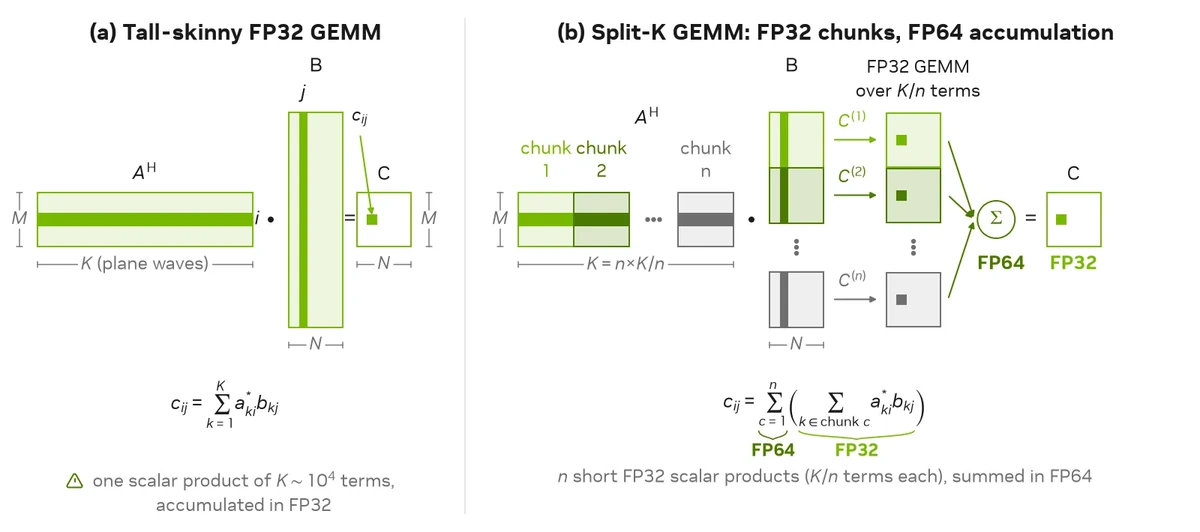
Auf H100 und H200, deren FP64-Tensor-Cores beim Durchsatz mit FP32 gleichauf liegen, ist der Gewinn gering. Auf der RTX PRO 6000 hingegen läuft der Davidson-Löser in FP32 3- bis 7-mal schneller, die gesamte Rechnung etwa 2-mal schneller. Die gemischte Genauigkeit wird über den Parameter LDAVIATOR_MIXED_PRECISION aktiviert (0 bedeutet FP64). Jeder ionische Schritt beginnt mit Datenspeicherung in FP32, bis DAVIATOR_EDIFF_FP32 oder DAVIATOR_SWITCH_TO_FP64_AFTER_STEP erreicht ist; für die meisten Eingaben eignen sich Werte von 10-4 bis 10-5. Im Beispiel sind EDIFF = 5e-07, LDAVIATOR = True, LDAVIATOR_MIXED_PRECISION = True, DAVIATOR_SWITCH_TO_FP64_AFTER_STEP = -2 und DAVIATOR_EDIFF_FP32 = 5e-05 gesetzt. Eine VASP-Lizenz ist erforderlich, und Daviator mit gemischter Genauigkeit wird über den ALCHEMI VASP Microservice auf jeder NVIDIA-GPU laufen.