Beschleunigung des Datenladens in die GPU mit NVIDIA KvikIO und GPUDirect Storage
 Public
- 22 Oct, 2026
NVIDIA Magnum IO GPUDirect Storage (GDS) löst das Flaschenhalsproblem beim Verschieben großer Datensätze vom Speicher auf Beschleuniger, indem es einen direkten Datenpfad ermöglicht, der das Zwischenspeichern im CPU-Speicher umgeht. Da KI-Modelle und Trainingsdatensätze exponentiell wachsen, ist eine effiziente Datenübertragung entscheidend, um die GPUs mit Daten zu versorgen. Während die primäre Schnittstelle zu GDS die cuFile C API ist, bleibt Python die dominierende Sprache in der modernen KI-Entwicklung. NVIDIA KvikIO schließt diese Lücke, indem es hochstufige, idiomatische Schnittstellen für Python und C++ für hochperformanten Datei-I/O bereitstellt. Es sitzt über cuFile und bietet zusätzliche Steuerelemente für die Ausführung von I/O-Anfragen, sodass Entwickler den Datenpfad verwalten können, ohne auf niedrige C-Code-Ebene absteigen zu müssen.
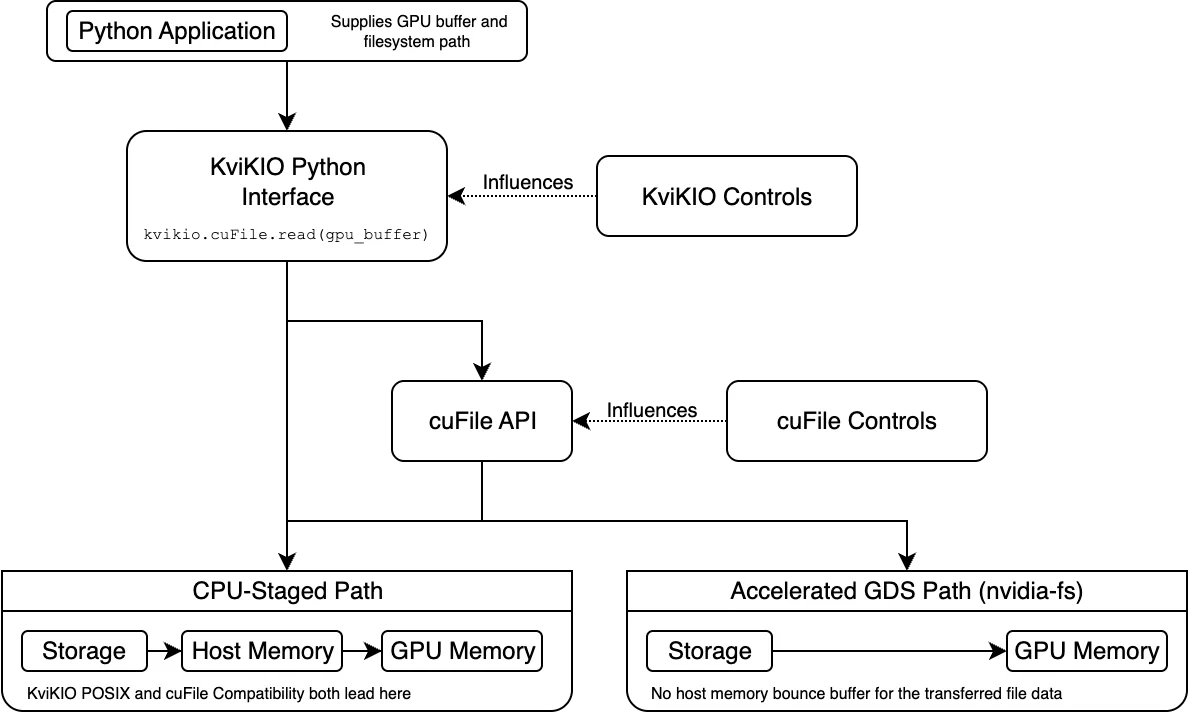
Die Architektur umfasst zwei separate Entscheidungspunkte für die Auswahl des Datenpfads. Erstens bestimmt KvikIO, ob ein Anfrage über cuFile gesendet oder der eigene POSIX-Kompatibilitätspfad verwendet wird, der Daten über den Host-Speicher leitet. Diese Wahl wird durch die Einstellung compat_mode beeinflusst, die AUTO, ON oder OFF sein kann. Im AUTO-Modus versucht KvikIO, cuFile zu verwenden, fällt aber auf POSIX zurück, wenn dieses nicht verfügbar ist. Zweitens entscheidet cuFile nach dem Empfang der Anfrage, ob der beschleunigte GDS-Pfad oder der eigene CPU-gestufte Kompatibilitätspfad verwendet wird, basierend auf der Systemunterstützung und Konfiguration. Daher bestätigt der Aufruf der cuFile-API nur die Auswahl durch KvikIO; er garantiert nicht, dass der beschleunigte GDS-Pfad verwendet wurde. Entwickler müssen den endgültigen Pfad überprüfen, um eine optimale Leistung sicherzustellen.
Zunächst richten Sie eine Python-Umgebung ein und installieren Sie den CUDA-13-Build von KvikIO mit pip install kvikio-cu13, wobei CuPy als Abhängigkeit enthalten ist. Bevor Sie E/A-Vorgänge ausführen, prüfen Sie die aktive Konfiguration über die KvikIO-Standard-API. Wichtige Einstellungen umfassen compat_mode, der den aktiven Modus meldet, und gds_threshold, die minimale Anfragegröße, die an cuFile gesendet wird. Auf dem Testsystem beträgt der Schwellenwert 16 KiB, was bedeutet, dass kleinere Lesevorgänge direkt über den KvikIO-POSIX-Pfad ausgeführt werden. Diese Einstellungen können über Umgebungsvariablen wie KVIKIO_COMPAT_MODE und KVIKIO_GDS_THRESHOLD gesteuert werden. Zusätzlich kann das Skript gdscheck.py verwendet werden, um installierte GDS-Komponenten, unterstützte Dateisysteme und die aktive cuFile-Konfiguration auf der Plattform zu überprüfen.
Um Daten in den GPU-Speicher zu lesen, reservieren Sie ein CuPy-Array der geeigneten Größe und verwenden Sie den Kontextmanager kvikio.CuFile für den Lesevorgang. Zum Beispiel erfordert das Lesen einer 1-GiB-Datei die Erstellung eines 1-GiB-CuPy-Puffers und dessen Übergabe an die read-Methode. Um den Datenpfad zu überprüfen, aktivieren Sie die cuFile-Laufzeitstatistiken, indem Sie die Umgebungsvariable CUFILE_STATS_LEVEL=3 setzen und das Skript im interaktiven Modus ausführen. Verwenden Sie dann gds_stats, um die Zähler zu inspizieren. In der Ausgabe pro GPU zählt nvfs Operationen, die den nvidia-fs-Kernel-Modul (beschleunigter Pfad) verwenden, während posix Operationen zählt, die den Kompatibilitätspfad verwenden. Mit den Standardeinstellungen wird ein 1-GiB-Lesevorgang in 256 Operationen à 4 MiB aufgeteilt, wobei alle nvfs=256 und posix=0 anzeigen, was die Verwendung des beschleunigten Pfads bestätigt.
Weitere Kontrolle ist möglich, indem die Einstellungen von KvikIO und cuFile unabhängig voneinander manipuliert werden. Das Setzen von KVIKIO_COMPAT_MODE=off zwingt KvikIO, cuFile zu verwenden, während CUFILE_FORCE_COMPAT_MODE=true cuFile zwingt, seinen Kompatibilitätspfad zu verwenden, was zu posix-Zählern in den Statistiken führt. Umgekehrt umgeht KVIKIO_COMPAT_MODE=on cuFile vollständig und verwendet das CPU-gestufte Backend von KvikIO. Neben der Pfadauswahl steuern Ausführungsparameter in cufile.json, wie Anfragen verarbeitet werden. KvikIO teilt große Operationen basierend auf KVIKIO_TASK_SIZE in Aufgaben auf, die dann an cuFile gesendet werden. cuFile kann diese Anfragen basierend auf seinem internen Thread-Pool und min_io_threshold_size_kb weiter aufteilen. Beispielsweise führt eine 1-GiB-Anfrage mit einer Aufgaben大小为 4 MiB zu 256 separaten cuFile-Anfragen, die jeweils als einzelnes Stück verarbeitet werden.
Wenn KvikIO eine einzelne große Anfrage (z. B. 1 GiB) an cuFile sendet, kann cuFile diese in kleinere Teile aufteilen, um eine parallele Verarbeitung zu ermöglichen, die durch die Anzahl der Worker-Threads und max_request_parallelism begrenzt ist. In einer Konfiguration mit vier Workern wird eine Anfrage von 1 GiB in vier Teile à 256 MiB aufgeteilt. Da der Zielpuffer nicht für Storage-DMA registriert ist, verwendet cuFile einen registrierten GPU-Bounce-Puffer und kopiert Daten in Blöcken von maximal 16 MiB. Die Einstellung min_io_threshold_size_kb beeinflusst die Planung der Anfragen; so kann beispielsweise eine Anfrage von 16 MiB in zwei Teile à 8 MiB aufgeteilt werden, um den Schwellenwert zu erfüllen. KvikIO ist Teil der CUDA-X-Bibliotheken und wurde in cuDF, cuCIM und cuPhoton eingesetzt, um die Datenerfassung für Parquet, ORC und wissenschaftliche Bilder zu beschleunigen. Das Verständnis dieser Ebenen ermöglicht es Entwicklern, die I/O-Leistung für spezifische Workloads zu optimieren.