Optimizacija AI inferencije putem zajedničkog projektiranja memorije na svim razinama steka
 Public
- 06 Nov, 2026
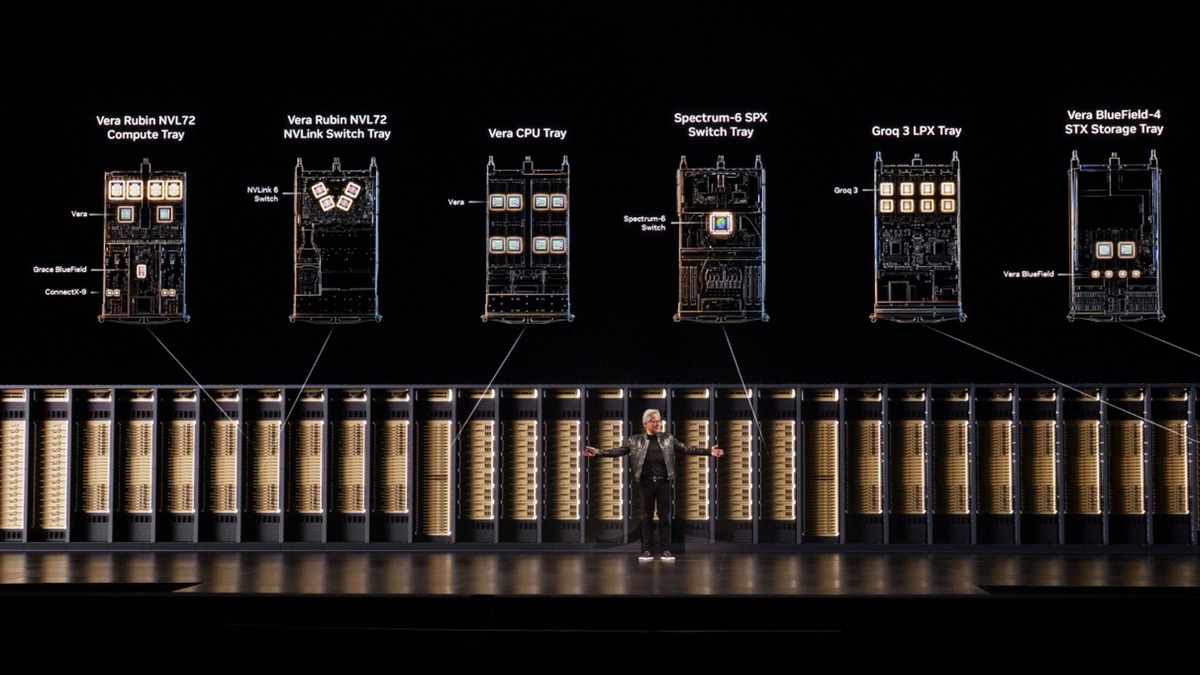
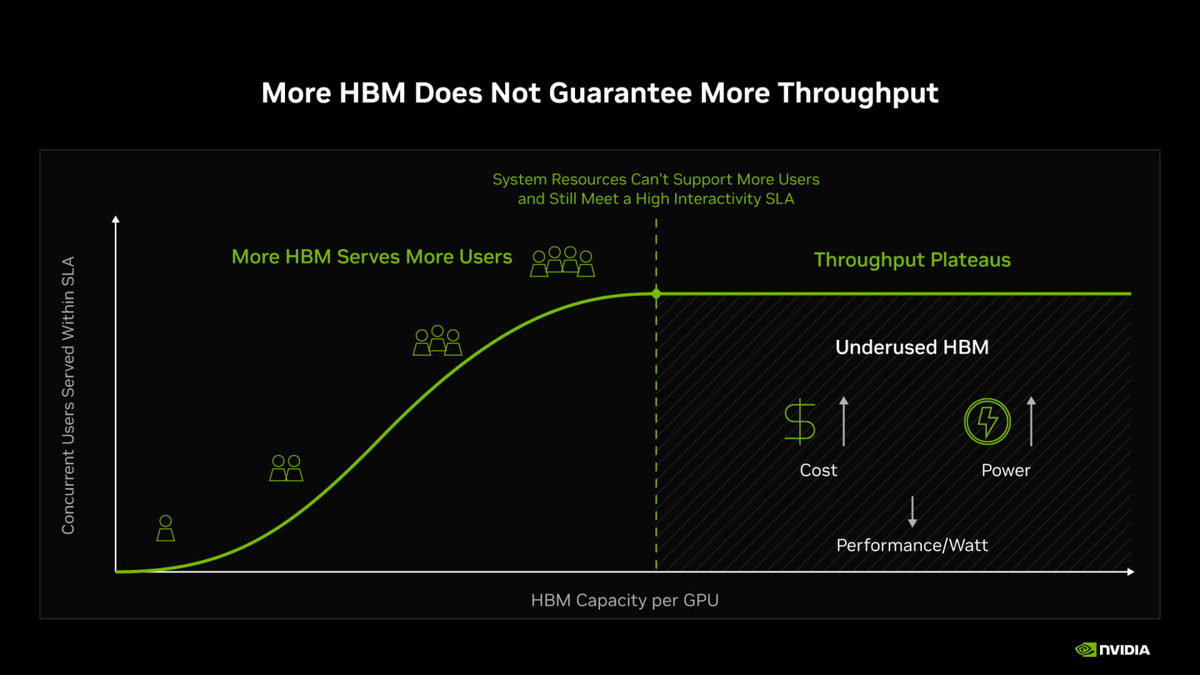
Brzi rast velikih jezičnih modela, proširenje kontekstnih prozora i širenje agencijskih aplikacija pojačavaju pritisak na resurse GPU memorije. U uvjetima zatezanja opskrbe i rasta cijena, industrija se suočava s ključnim izazovom: kako obraditi više podataka bez jednostavnog dodavanja skupog hardvera. NVIDIA se tome suočava odstupanjem od tradicionalnog pristupa pakiranja veće količine memorije High Bandwidth Memory (HBM) na čipove. Umjesto toga, tvrtka primjenjuje strategiju cjelovite zajedničke izrade (full-stack codesign), u kojoj se GPU, CPU, mrežna oprema, pohrana i softver projektiraju u tandemu. Ovaj holistički pristup cilja izvući maksimalno korisno poslovanje iz svakog bajta memorije u cijeloj infrastrukturi AI fabrike, umjesto da se oslanja isključivo na povećanje sirove kapaciteta.
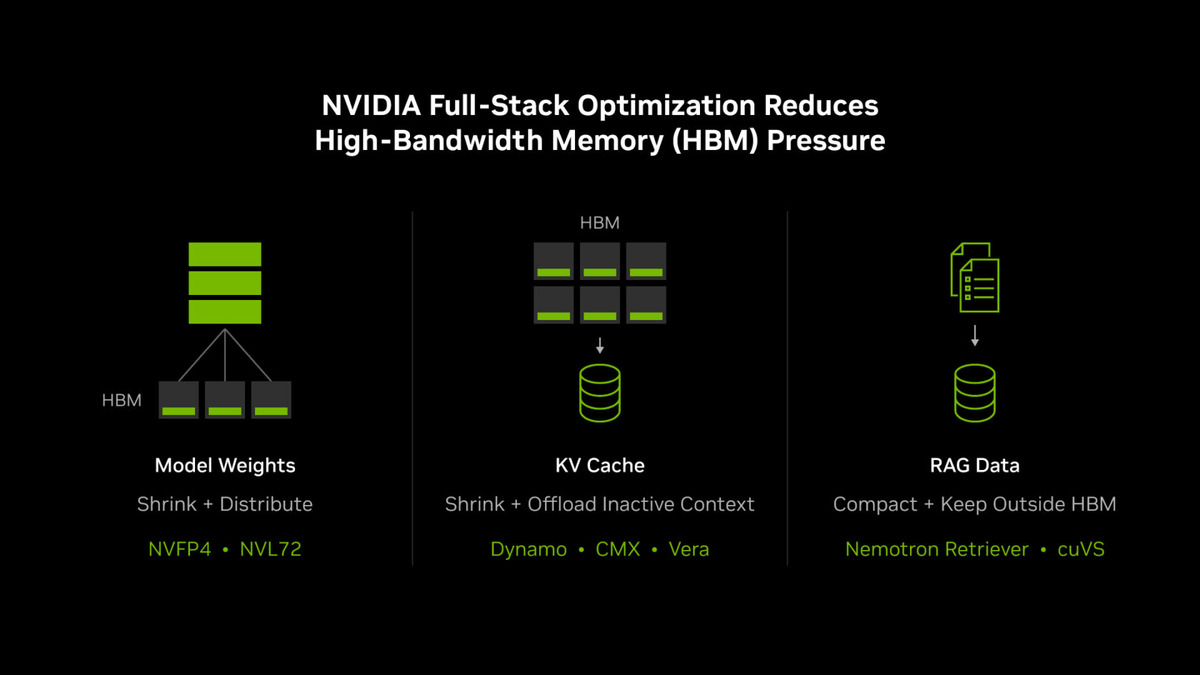
Srž ove strategije leži u učinkovitom upravljanju hijerarhijom memorije i pohrane. U AI fabrici, HBM služi kao najbrži, ali najskuplji i najtraženiji sloj, koji čuva ključne podatke poput težina modela i Key-Value (KV) keša. Ispod ovog sloja nalaze se CPU memorija, lokalni SSD-ovi i zajednička pohrana, koji nude veću kapacitetu za niže troškove, ali s manjom brzinom. Učinkovitost sustava ovisi o tome koliko dobro se podaci smještaju i premještaju između tih slojeva. Smanjenjem otiska težina modela, ispunjenjem neaktivnih KV keš konteksta u jeftiniju pohranu i kompaktiranjem RAG embeddinga, NVIDIA osigurava da ograničeni prostor HBM-a bude rezerviran za aktivne, visokoprioritetne operacije. To sprječava fenomen "zida memorije", u kojem jedinice za izračun čekaju podatke jer je propusnost zasićena, čime se održava niska latencija za istovremene korisnike.
Utjecaj ovog pristupa kodizajnu jasno se vidi u nedavnim metrikama performansi platformi. Od generacije Blackwell Ultra do nadolazeće platforme Vera Rubin, kapacitet HBM po GPU-u porastao je za svega oko 3%. Međutim, poboljšanja u učinkovitosti su značajna. U benchmarku SemiAnalysis AgentX, propusnost agencijskih zadataka po dolaru porasla je do 30 puta. Konkretno, NVIDIA GB300 NVL72 osigurava do 10 puta veću propusnost po dolaru u usporedbi s platformom H200 pri brzini od 100 tokena u sekundi po korisniku, unatoč udvostručenju kapaciteta HBM. Očekuje se da će Vera Rubin NVL72 osigurati do 30 puta veću propusnost po dolaru u usporedbi s GB300 NVL72 pri brzini od 125 tokena u sekundi po korisniku, uz povećanje kapaciteta HBM od samo 3%. To pokazuje da optimizacija protoka podataka i smještaja u pohrani donosi znatno veći prinos nego samo proširenje kapaciteta memorije.
Za operatore AI-fabriklja ključna metrika je broj korisnih tokena isporučenih unutar specifičnog energetskog proračuna uz ispunjenje strogih zahtjeva za vrijeme odziva. Povećanje broja tokena u sekundi po vatu izravno vodi do veće prihoda od iste energetske infrastrukture i niže cijene po tokenu. Smanjenjem opterećenja HBM-a zbog težina modela, neaktivnog konteksta i podataka RAG-a, potpuni kodizajn osigurava da se resursi memorije koriste za aktivni inferenc, a ne za pasivno pohranjivanje. Ova metoda omogućuje sustavima da obrađuju trilijune parametara i složene agencijske trajektorije, koje mogu uključivati obradu do 3 milijuna tokena, bez uskih grla uzrokovanih propusnošću memorije. Rezultat je skalabilnija i ekonomičnija infrastruktura sposobna podržati sljedeću generaciju AI-aplikacija.