NVIDIA Snapshot skraćuje pokretanje GPU radnih opterećenja na sekunde
 Public
- 11 Nov, 2026
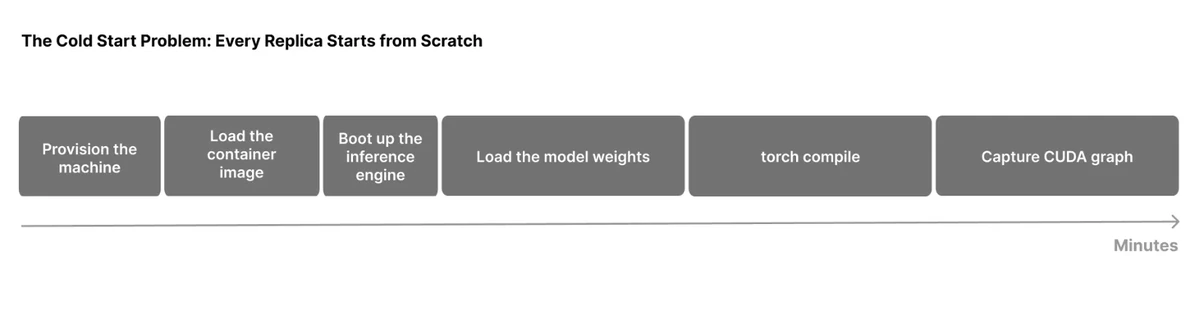
NVIDIA je predstavila Snapshot, otvorenu komponentu platforme NVIDIA DSX AI Factory Platform koja omogućuje ponovno korištenje inicijaliziranih GPU radnih opterećenja u različitim replikama inferencije. Problem je poznat svima koji poslužuju LLM: kada potražnja naglo poraste ili replika otkaže, slobodni GPU-i ne postaju odmah kapacitet za posluživanje jer inicijalizacija LLM radnog opterećenja, hladni start, može trajati minutama. Snapshot je sustav kontrolnih točaka i vraćanja za GPU radna opterećenja u Kubernetesu. On sprema potpuno inicijalizirano radno opterećenje, uključujući memoriju CPU-a i GPU-a, i vraća to stanje na kompatibilnoj infrastrukturi, stavljajući kapacitet inferencije u mrežu za sekunde, a ne za minute. Priprema infrastrukture i učitavanje slike kontejnera nisu dio mjerenog puta vraćanja.
Alat nudi dvije operacije za GPU podove, a obje se upravljaju putem prilagođenih resursa Kubernetesu. Da biste spremili kontrolnu točku pokrenutog poda, stvarate PodSnapshot s njegovim imenom; da biste pokrenuli pod iz predloška i odmah spremili njegovu kontrolnu točku kada bude spreman, stvarate SnapshotJob. Vraćanje znači dodavanje anotacije nvidia.com/restore-from novom podu i navođenje PodSnapshot iz kojeg se treba vratiti. Samo radno opterećenje zahtijeva tek mali handshake kako bi se pauziralo prije stvaranja kontrolne točke i nastavilo s radom nakon vraćanja, a u repozitoriju postoje gotovi primjeri za vLLM, SGLang i NVIDIA TensorRT LLM. Snapshot može spremati i vraćati kompatibilna radna opterećenja koja obuhvaćaju više GPU-a na jednom čvoru kao jedan artefakt po svim rangovima, što omogućuje brzo pokretanje velikih mixture-of-experts modela s tenzorskim paralelizmom, paralelizmom podataka i eksperata te paralelizmom konteksta dekodiranja, pod uvjetom da radno opterećenje zadovoljava zahtjeve kompatibilnosti kontrolnih točaka, vraćanja i izvršnog okruženja.
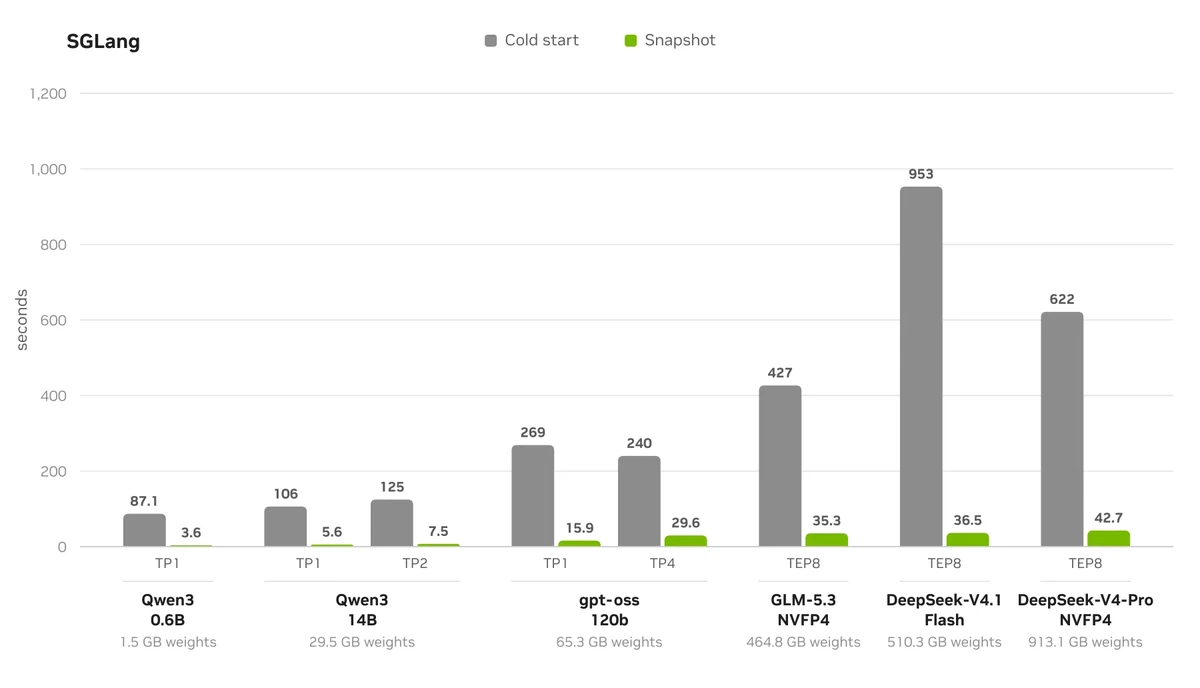
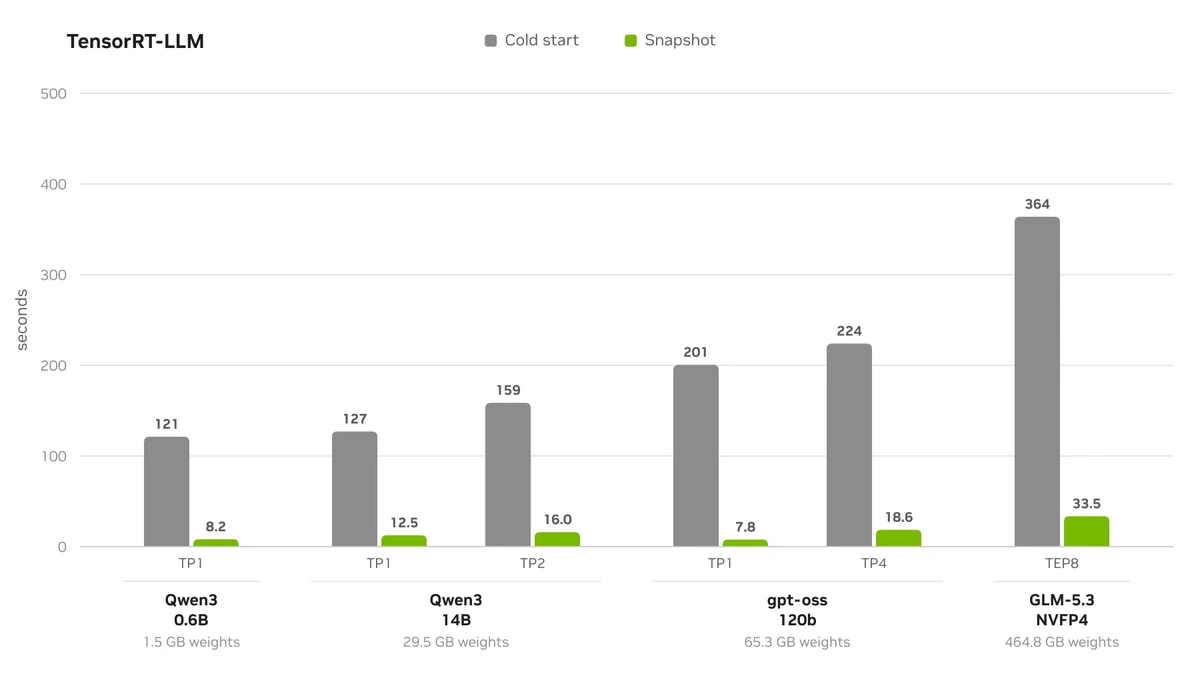
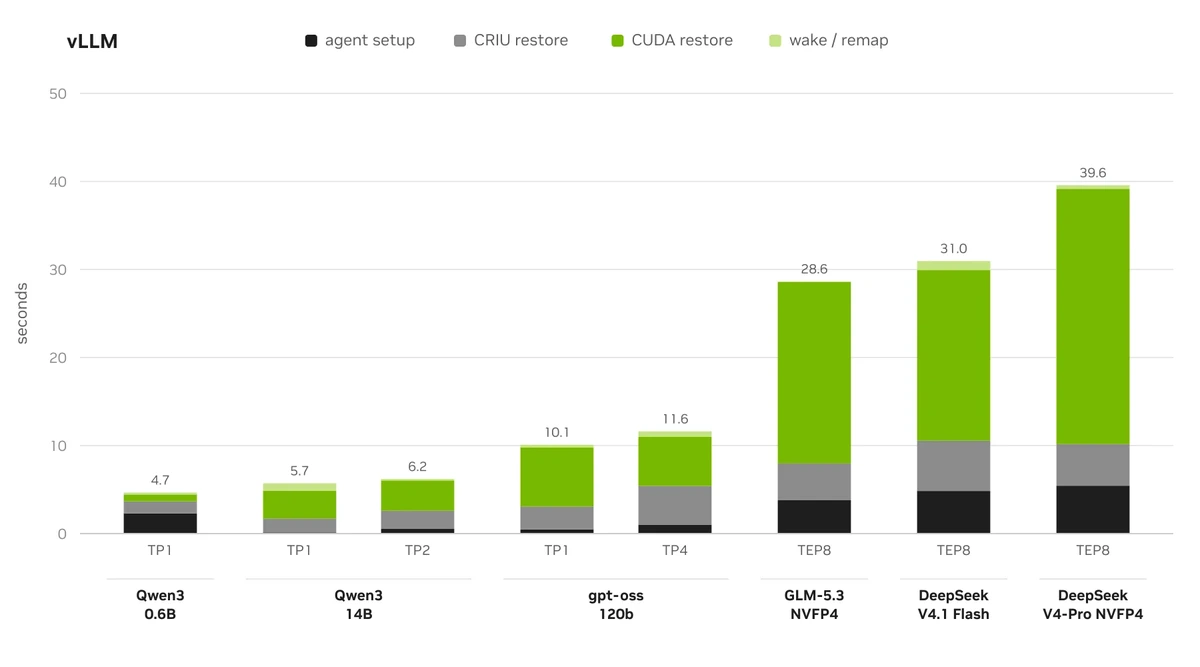
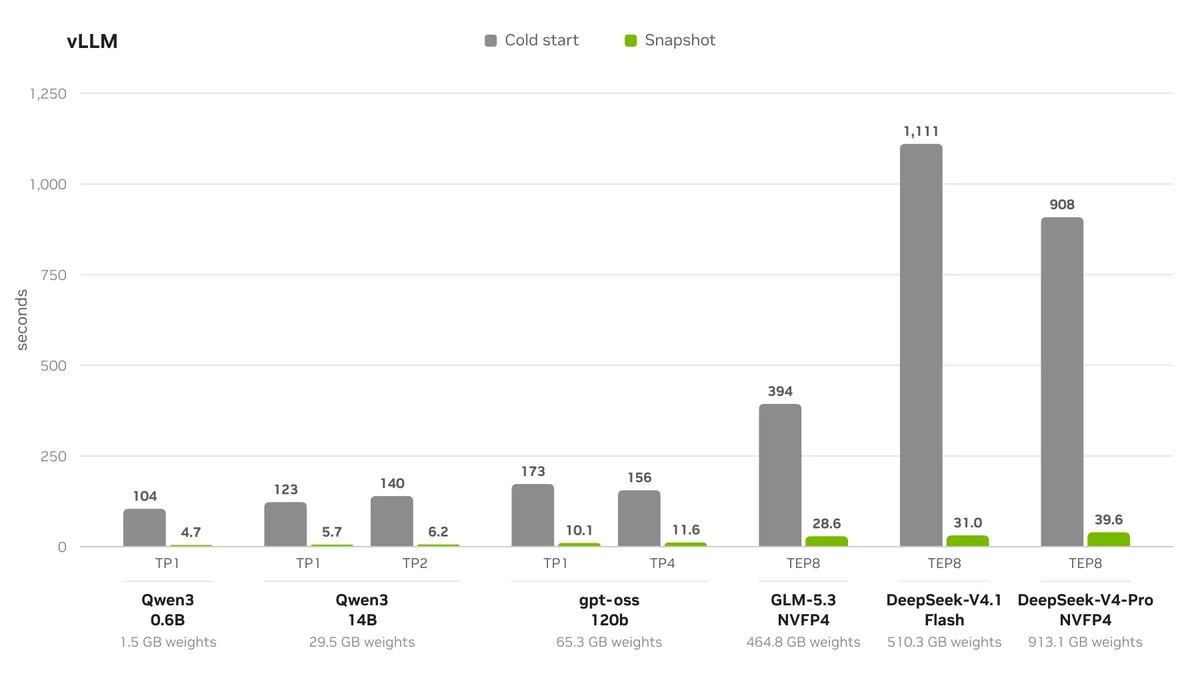
Benchmarkovi obuhvaćaju modele od 600 milijuna parametara do MoE modela s kontrolnim točkama od 1 TB na 8 GPU-a; testovi su provedeni na istoj opremi i softverskom stacku prema dvije strategije: hladno pokretanje nasuprot vraćanju iz Snapshot. U svim testiranim konfiguracijama Snapshot vraća repliku u pogon za manje od 45 sekundi - 8 do 36 puta brže od hladnog pokretanja. Po motorima rasponi vraćanja su sljedeći: vLLM - od 4,7 do 39,6 sekundi, SGLang - od 3,6 do 42,7 sekundi, TensorRT LLM - od 7,79 do 33,55 sekundi. Oba mjerenja ne uključuju učitavanje slike kontejnera i postavljanje runtime okruženja kontejnera, a oslobađanje KV cachea pokreće se prije svake kontrolne točke pa stoga nije dio artefakta. Vrijeme izrade kontrolne točke i veličina artefakta navedeni su kao jednokratni trošak po modelu i konfiguraciji.
Sam put vraćanja sastoji se od postavljanja agenta, vraćanja CRIU, vraćanja CUDA i buđenja s ponovnim mapiranjem, a raščlamba hladnog pokretanja pokazuje koje faze inicijalizacije vraćanje preskače. Snapshot je izvorno razvijen za inferencijske workere NVIDIA Dynamo, ali je zamišljen za integraciju s drugim inferencijskim motorima, schedulerima, kontrolerima i platformama. Alati za benchmarking i upute za reprodukciju nalaze se u repozitoriju zajedno s uputama za instalaciju i korištenje, a korisnički priručnik za Dynamo opisuje vraćanje workera. Razvojni partneri također su ocijenili Snapshot na svojim radnim opterećenjima.