Daviator ubrzava VASP na NVIDIA GPU-ovima: skupna obrada k-točaka i miješana preciznost
 Public
- 18 Nov, 2026
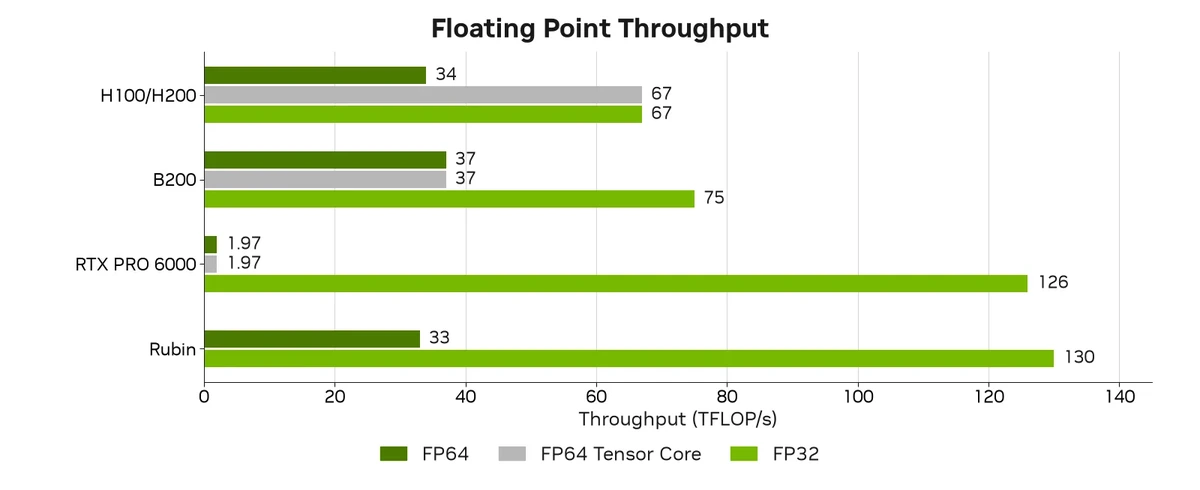
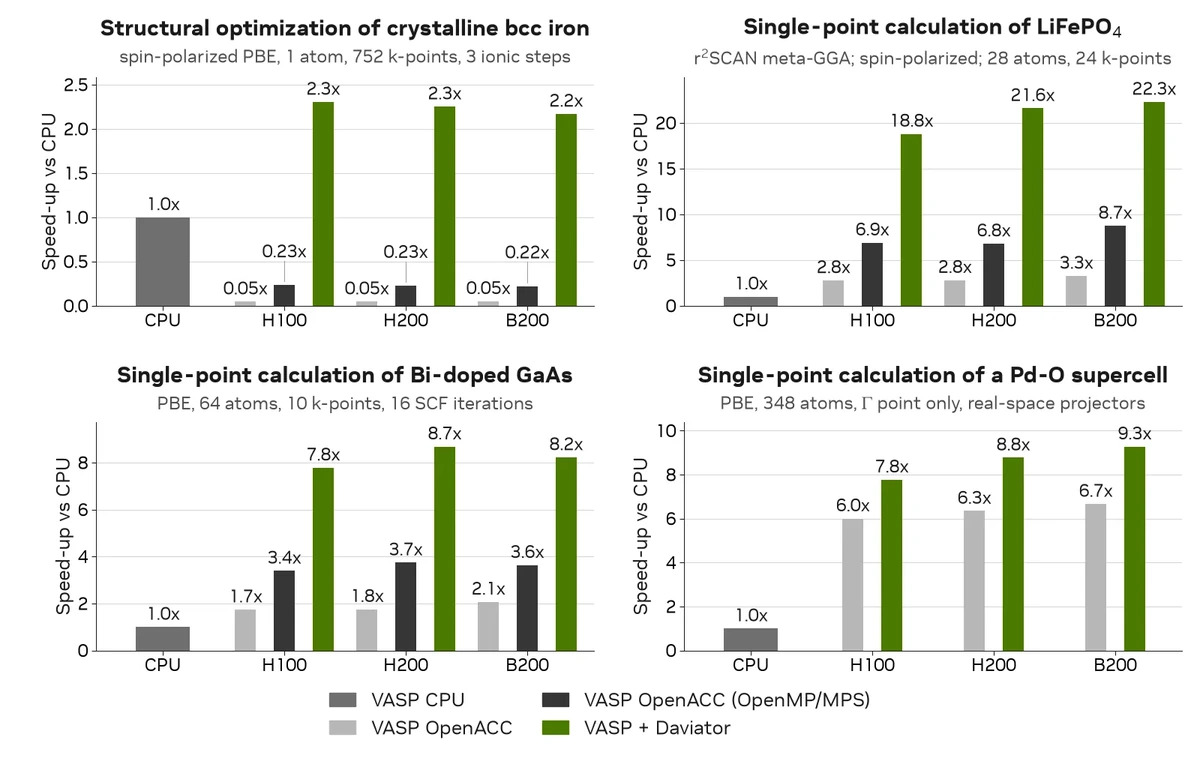
Za treniranje interatomskih potencijala temeljenih na strojnom učenju (MLIP) potrebne su desetci do stotine milijuna DFT izračuna energija, sila i naprezanja. Najčešće se dobivaju u VASP-u, vodećem DFT kodu s ravnim valovima. Takvi zadaci obično koriste male jedinične ćelije i guste mreže k-točaka, zbog čega GPU-ovi ostaju neiskorišteni. OpenACC port VASP-a obrađuje k-točke jednu po jednu, pa se za male sustave u svakom koraku pokreću stotine sićušnih jezgri, a troškovi pokretanja odnose gotovo svo vrijeme. Sustav od jednog atoma željeza sa 752 k-točke radio je na GPU-u 8 puta sporije nego na CPU-u, pa su istraživači morali ručno raspoređivati zadatke prema veličini. Uz to FP64 stagnira: performanse u FP64 kod Hopper, Blackwell i Rubin arhitektura ne rastu, dok FP32 i dalje napreduje. RTX PRO 6000 ima omjer FP32:FP64 čak 64:1.
Daviator je NVIDIA biblioteka GPU jezgri koja petlje po k-točkama zamjenjuje grupnim (batched) operacijama. Temelji se na grupnom Davidsonovom rješavaču koji koristi grupne FFT-ove, GEMM-ove i vlastite jezgre. Pokretanja je manje, iskorištenost SM-ova približava se zasićenju, a podaci ne napuštaju GPU memoriju. VASP i dalje upravlja SCF petljom, miješanjem, simetrijom i ulazom/izlazom, a Daviator se uključuje na jasno definiranim točkama poziva. Aktivira se putem mikroservisa NVIDIA ALCHEMI VASP parametrom LDAVIATOR=True u datoteci INCAR i preuzima ulogu Davidsonovog rješavača (ALGO = Normal). Postojeće ulazne datoteke nije potrebno mijenjati. Primjer koristi jedan atom Fe s ISPIN = 2, NBANDS = 12, PREC = Accurate i mrežom 30x30x30 centriranom u Gama-točki.
Dio jezgri specijaliziran je za veličinu grupe i može se kompilirati pri prvoj upotrebi. Zato u skriptama poslova CUDA_CACHE_PATH treba usmjeriti na brzu pohranu, primjerice /tmp/cudacache, a ne u $HOME, te postaviti CUDA_CACHE_DISABLE=0. Izračuni se pokreću kao i obično, npr. mpirun -np 1 vasp_std. Zasad je podržan samo rad na jednom čvoru; podrška za više čvorova, vasp_ncl i vasp_gam je u planu. Za usporedbu su korišteni VASP 6.6.0 na CPU-u i s OpenACC-om na H100/H200 i B200. Jedan atom željeza računa se više od 2 puta brže nego na CPU-u. Za LiFePO4 s r2SCAN Davidsonov rješavač ubrzava se 22 puta, a za GaAs dopiran s Bi od 64 atoma vrijeme izračuna smanjuje se za više od 85%. Čak se i sustav od 348 atoma s jednom k-točkom računa brže, pa poslove više nije potrebno razvrstavati po veličini. Prema procjenama za skupove podataka, vrijeme do rezultata skraćuje se do 22 puta, a trošak do 75% u usporedbi s CPU-om.
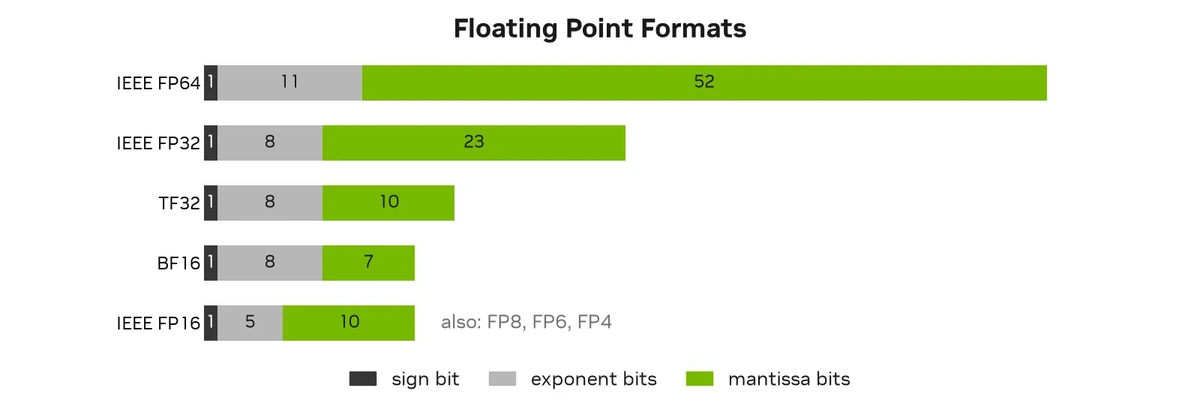
Grupni Daviator i dalje računa u FP64, a izrada Davidsonovog rješavača s mješovitom preciznošću nije jednostavna. Ako se jezgre prebace na FP32 i rezultat usporedi s FP64, dobiva se samo „prošlo" ili „nije prošlo". Pritom skrivene pogreške, poput pomaka energije, konvergencije prema pogrešnom rješenju ili divergentnih MD putanja, mogu izgledati sasvim uvjerljivo. Stoga se koristi generički tip s pomičnim zarezom s podesivim brojem bitova mantise i eksponenta. Pomoću njega za svaku jezgru utvrđuje se minimalna potrebna preciznost i odlučuje: prebaciti je na FP32, preraditi je ili zadržati kao „otok" FP64. Rezultati ovise o ulaznim podacima i pragu. Instrumentacija mora obuhvatiti i ovisnosti i matematičke funkcije, a spora instrumentirana izvođenja mogu se paralelizirati na HPC resursima. Počinje se s pretvorbama FP64↔FP32 oko kritičnog puta i jezgrama s podesivim tipom, a zatim se od iteracije do iteracije područja FP64 smanjuju.
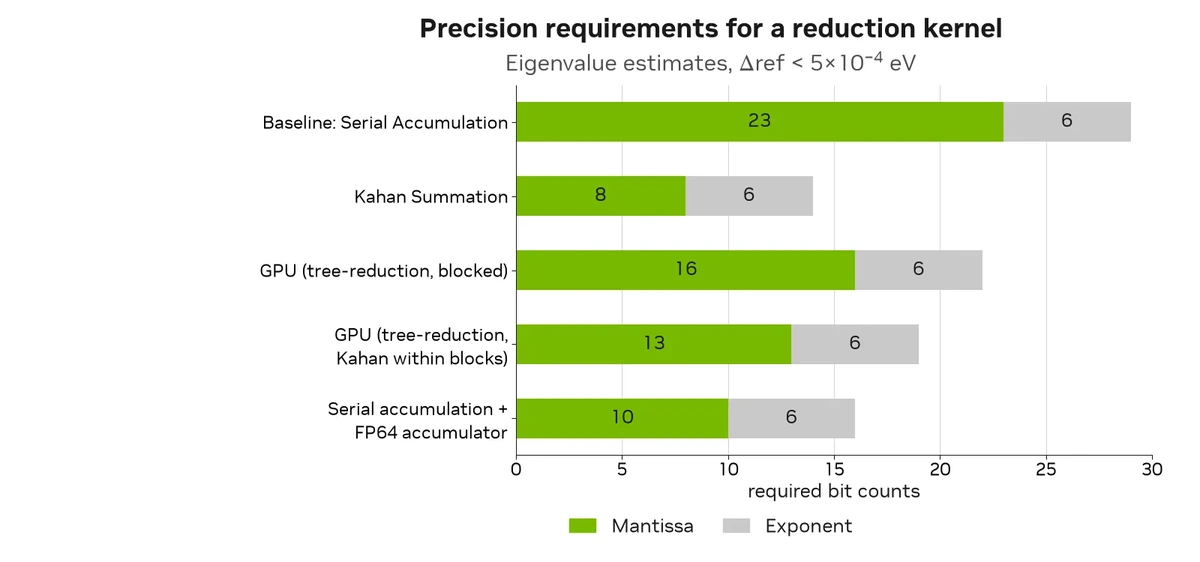
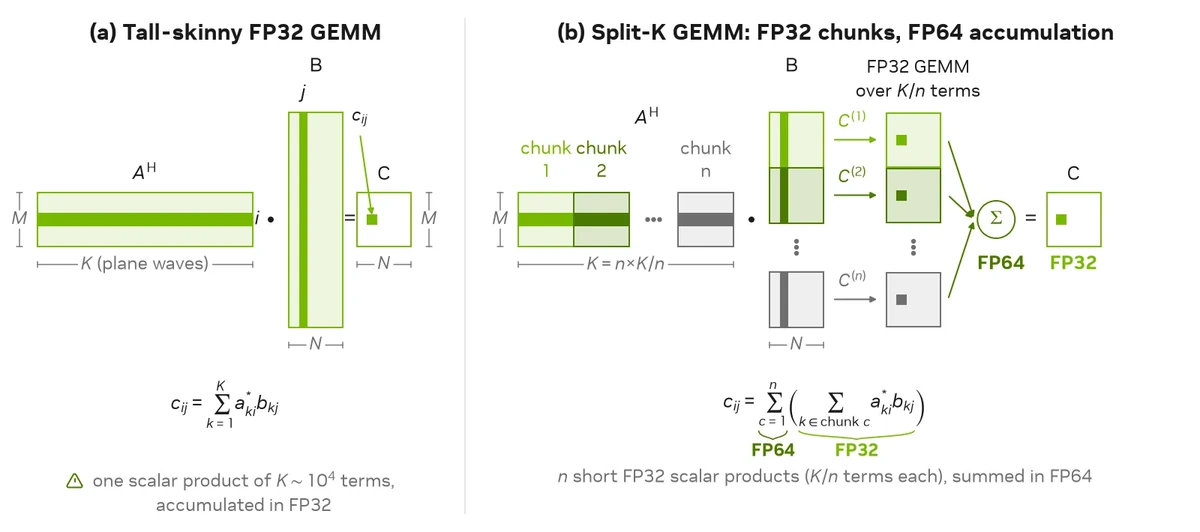
Analiza temeljena na alatu Verificarlo pokazala je da se FFT-ovi, primjena hamiltonijana i ažuriranje orbitala mogu prebaciti u FP32. Problem svojstvenih vrijednosti u potprostoru, energije, kriteriji konvergencije te visoki uski GEMM-ovi iz kojih se grade matrice potprostora ostali su u FP64. Ti Rayleigh-Ritzovi GEMM-ovi napajaju osjetljivi rješavač svojstvenih vrijednosti, pa se primjenjuje algoritam split-k: skalarni produkti računaju se u blokovima u FP32, a konačno zbrajanje odvija se u FP64. Prag EDIFF u VASP-u prema zadanim postavkama iznosi 10-4 eV i može se spustiti do 10-6 eV i niže, dok FP32 pruža oko 7 značajnih znamenki. Mješoviti rješavač konvergira do 10-4 do 10-6 eV, ovisno o ulaznim podacima, a ispod razine šuma FP32 izračun se nastavlja u FP64. Na GaAsBi-64 FP32 daje dvostruko ubrzanje pri EDIFF = 10-5 eV, a kombinacija FP32→FP64 pri 10-8 eV radi 1,5 puta brže od čistog FP64.
Na H100 i H200, čije FP64 Tensor jezgre po propusnosti ne zaostaju za FP32, dobitak je malen. No na RTX PRO 6000 Davidsonov rješavač u FP32 radi 3 do 7 puta brže, a cijeli izračun otprilike 2 puta brže. Mješovita preciznost uključuje se parametrom LDAVIATOR_MIXED_PRECISION (0 znači FP64). Svaki ionski korak počinje s pohranom podataka u FP32 dok se ne dosegne DAVIATOR_EDIFF_FP32 ili DAVIATOR_SWITCH_TO_FP64_AFTER_STEP; za većinu ulaznih podataka prikladno je 10-4 do 10-5. U primjeru su postavljeni EDIFF = 5e-07, LDAVIATOR = True, LDAVIATOR_MIXED_PRECISION = True, DAVIATOR_SWITCH_TO_FP64_AFTER_STEP = -2 i DAVIATOR_EDIFF_FP32 = 5e-05. Potrebna je licenca za VASP, a Daviator s mješovitom preciznošću radit će na bilo kojem NVIDIA GPU-u putem mikroservisa ALCHEMI VASP.