Optimización de un pipeline de procesamiento de imágenes en CUDA: de los errores a los benchmarks
 Public
- 02 Sep, 2026
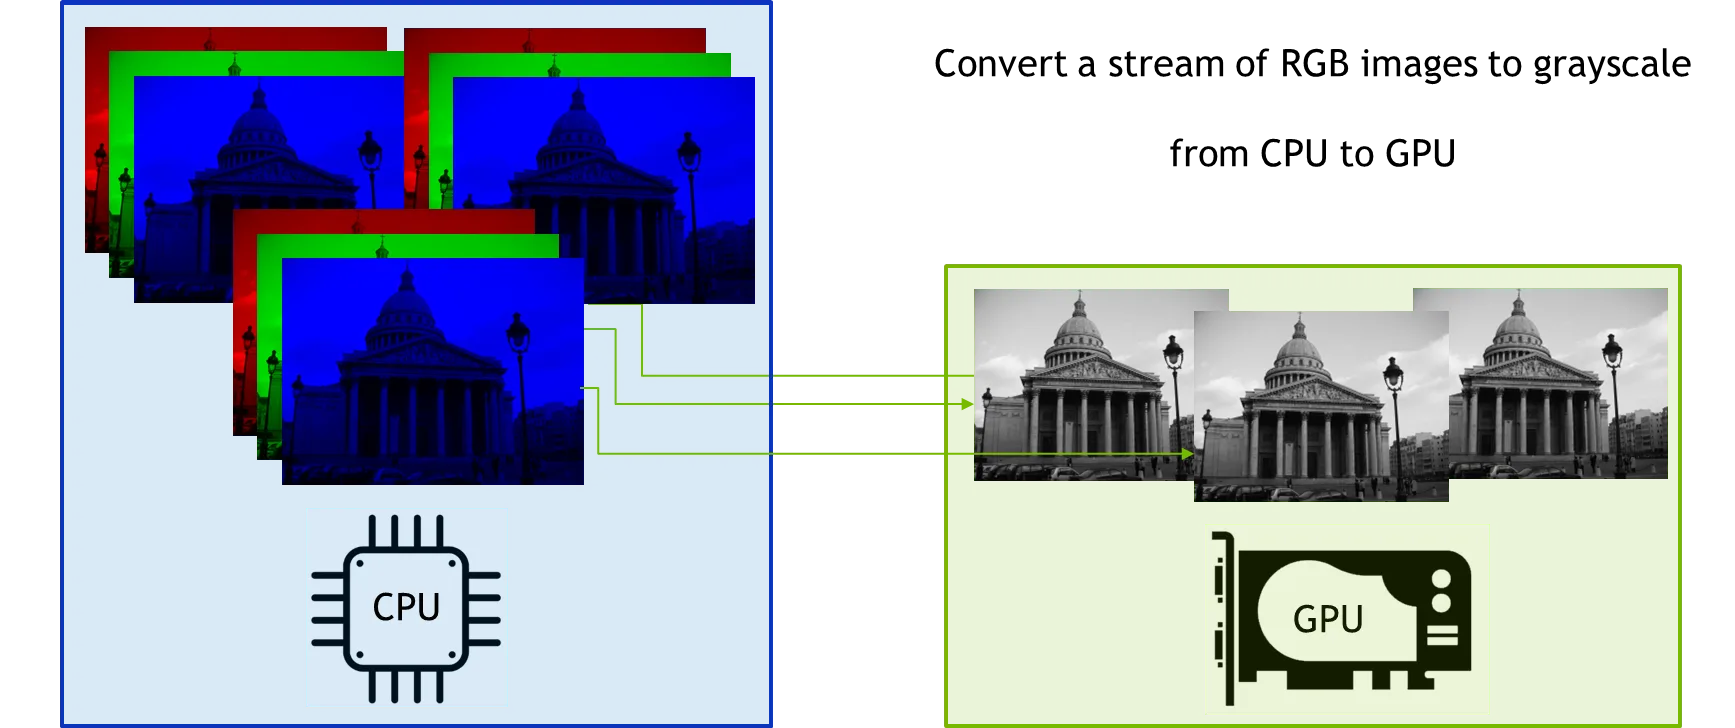
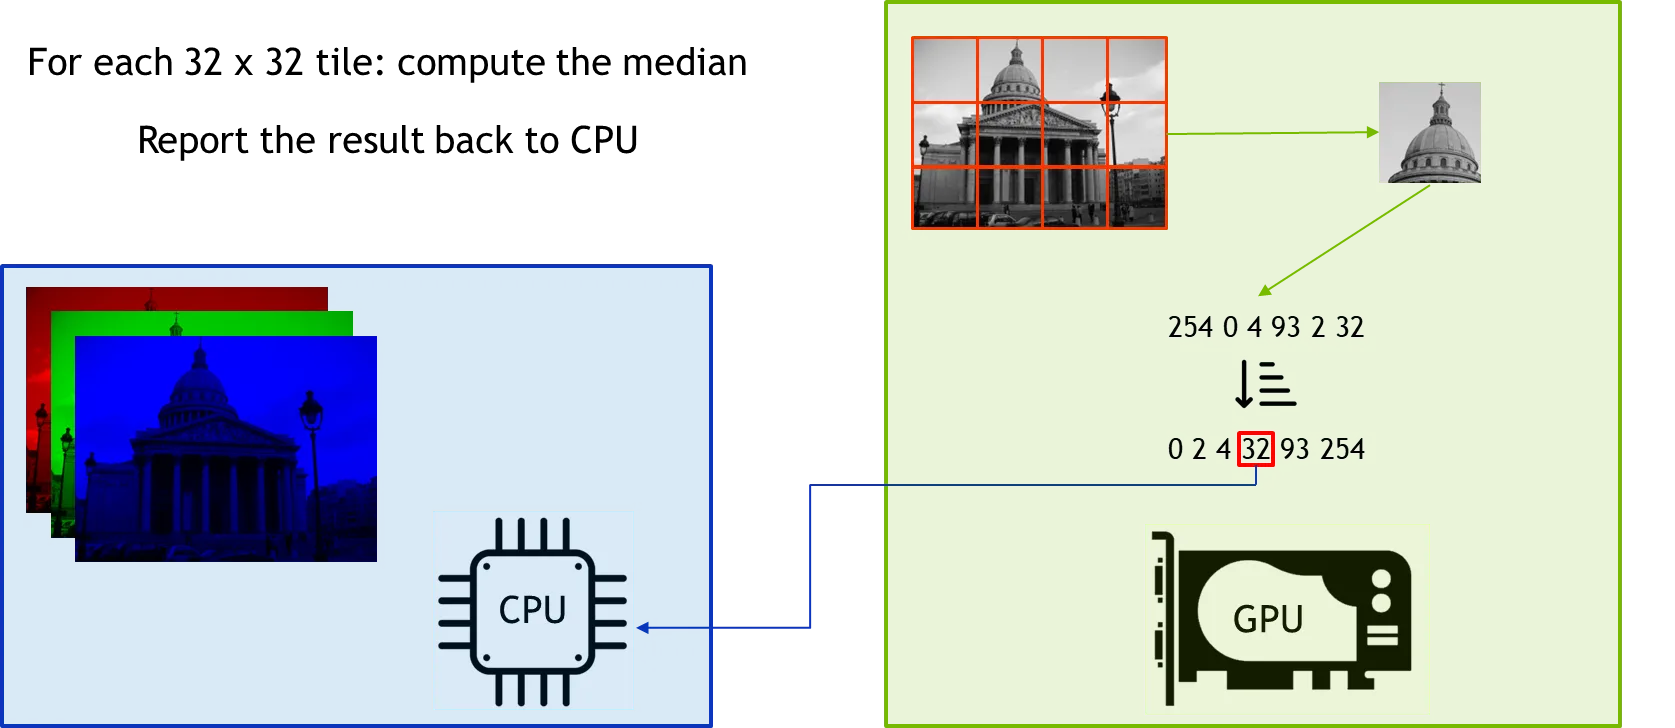
Este ejemplo práctico de CUDA procesa un flujo de imágenes rojas, verdes y azules: los datos se copian primero de la CPU a la GPU, se convierten de RGB a escala de grises, luego cada tesela de 32 por 32 píxeles se ordena para poder calcular su mediana y, por último, las medianas se copian de vuelta al host. La implementación inicial define dos kernels: computeRGBToGray para la conversión de color y computeMedian<TILE_WIDTH, HISTO_SIZE> para la mediana de cada tesela, mientras que main asigna memoria, lanza los kernels y libera recursos dentro de un bucle paralelo de OpenMP sobre tres imágenes.
El kernel de la mediana tiene un defecto sutil pero grave. La escritura en la memoria compartida tile[index] = d_image_gray[index] usa por error un índice global para escribir en la memoria compartida, que está limitada a un bloque de hilos. Al ejecutar el binario se produce el error «illegal memory access», y compute-sanitizer señala con precisión la causa: una escritura fuera de los límites __shared__ de un byte en la línea 55, registrada para el hilo (0,3,0) en el bloque (20,0,0).
Para evitar este tipo de errores de indexación, NVIDIA ha presentado en CCCL una nueva API de lanzamiento. Los kernels se lanzan mediante cuda::make_config, cuda::block_dims, cuda::grid_dims y cuda::launch, luego el kernel recibe la configuración como primer parámetro y usa cuda::gpu_thread.index(cuda::grid, config) y cuda::gpu_thread.index(cuda::block, config), para obtener por separado los índices global y de bloque. Los punteros sin procesar también se pueden sustituir por cuda::std::span, cuda::std::mdspan y cuda::shared_memory_mdspan, que en modo de depuración activan aserciones cuando se produce un acceso fuera de los límites del arreglo.
Cuando el código ya no tiene errores, se mide su rendimiento con Nsight Systems. Marcar el código con rangos NVTX, como nvtx3::scoped_range y nvtxRangePushA/nvtxRangePop : hace que la línea de tiempo sea más fácil de leer y muestra que el kernel de cálculo de la mediana domina el perfil: ocupa alrededor de 2,1 segundos por imagen y representa el 98,5 % del tiempo de GPU, mientras que las operaciones de memoria solo suponen el 1,5 %.
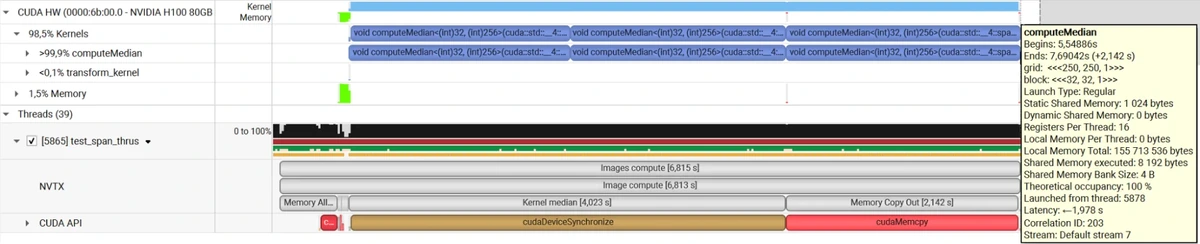
Desde el lado de la CPU, toda la fase de cálculo de la imagen dura 6,8 segundos, y casi todo ese tiempo se va en los kernels de la mediana. Esta línea de tiempo ofrece al desarrollador un objetivo claro para los siguientes pasos de optimización: el cálculo de la mediana es, con diferencia, la parte más costosa del flujo de procesamiento, y las etapas posteriores de la guía se centran precisamente en mejorarlo.