NVIDIA Snapshot reduce a segundos el arranque de las cargas de trabajo en GPU
 Public
- 11 Nov, 2026
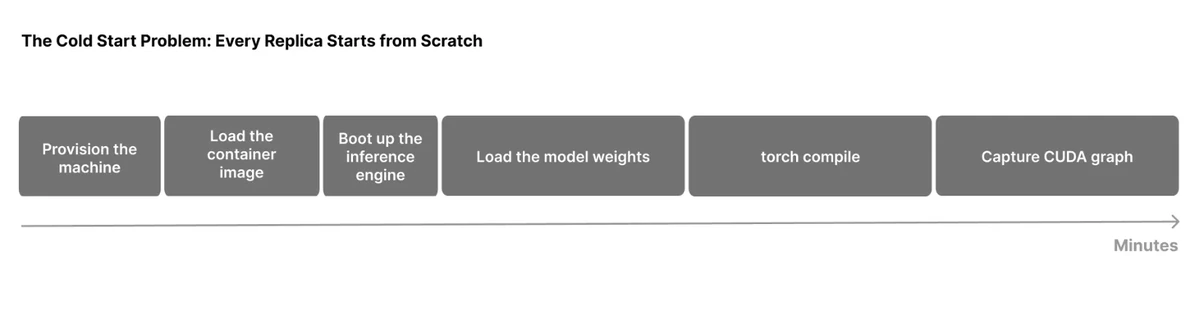
NVIDIA ha presentado Snapshot, un componente abierto de la plataforma NVIDIA DSX AI Factory Platform que permite reutilizar las cargas de trabajo en GPU ya inicializadas entre distintas réplicas de inferencia. El problema le resulta familiar a cualquiera que sirva LLM: cuando la demanda se dispara o una réplica falla, las GPU libres no se convierten de inmediato en capacidad de servicio, porque la inicialización de una carga de trabajo de LLM (el arranque en frío) puede tardar minutos. Snapshot es un sistema de puntos de control y restauración para cargas de trabajo en GPU en Kubernetes. Guarda una carga de trabajo completamente inicializada, incluida la memoria de CPU y de GPU, y restaura ese estado en una infraestructura compatible, poniendo en línea la capacidad de inferencia en segundos y no en minutos. El aprovisionamiento de la infraestructura y la carga de la imagen del contenedor quedan fuera de la ruta de restauración medida.
La herramienta ofrece dos operaciones para los pods con GPU, ambas controladas mediante recursos personalizados de Kubernetes. Para crear un punto de control de un pod en ejecución, se crea un PodSnapshot que lo nombre; para iniciar un pod a partir de una plantilla y crear su punto de control en cuanto esté listo, se crea en su lugar un SnapshotJob. Restaurar consiste en añadir la anotación nvidia.com/restore-from a un pod nuevo e indicar el PodSnapshot desde el que se restaurará. La propia carga de trabajo solo necesita un pequeño protocolo de intercambio (handshake) para pausarse antes del punto de control y reanudarse tras la restauración, y el repositorio incluye ejemplos listos para usar con vLLM, SGLang y NVIDIA TensorRT LLM. Snapshot puede guardar y restaurar cargas de trabajo compatibles que abarcan varias GPU en un único nodo como un solo artefacto para todos los rangos, lo que permite un arranque rápido de grandes modelos mixture-of-experts con paralelismo tensorial, paralelismo de datos y de expertos, y paralelismo de contexto de decodificación, siempre que la carga de trabajo cumpla los requisitos de compatibilidad de puntos de control, restauración y entorno de ejecución.
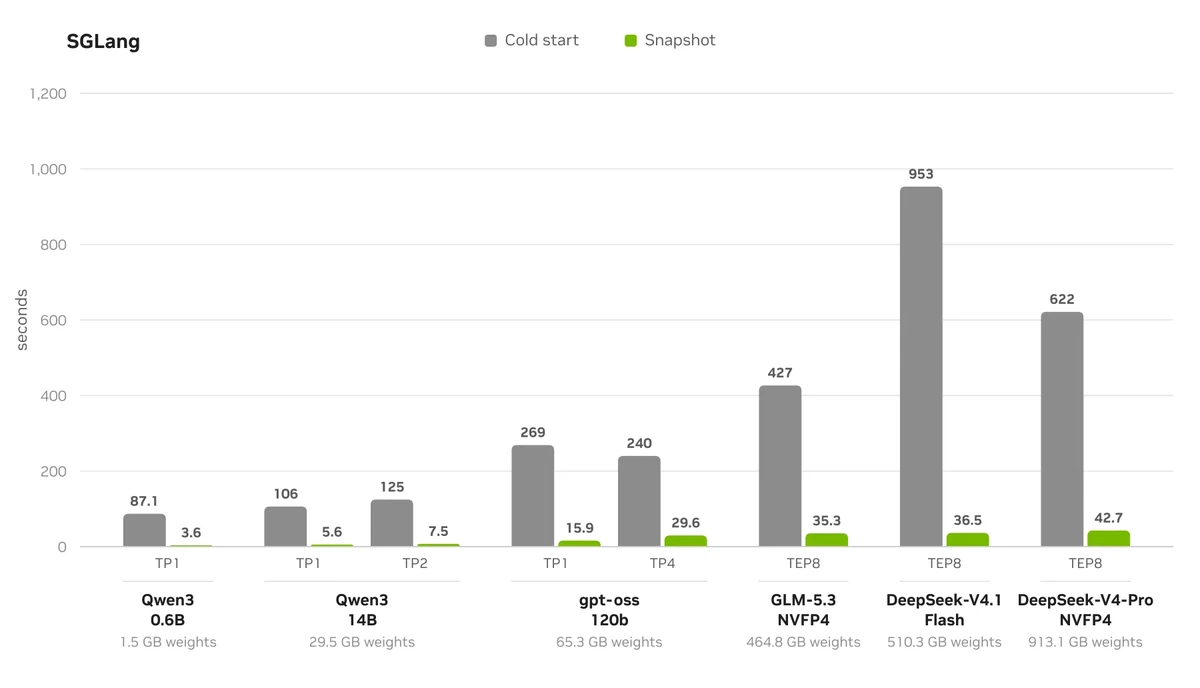
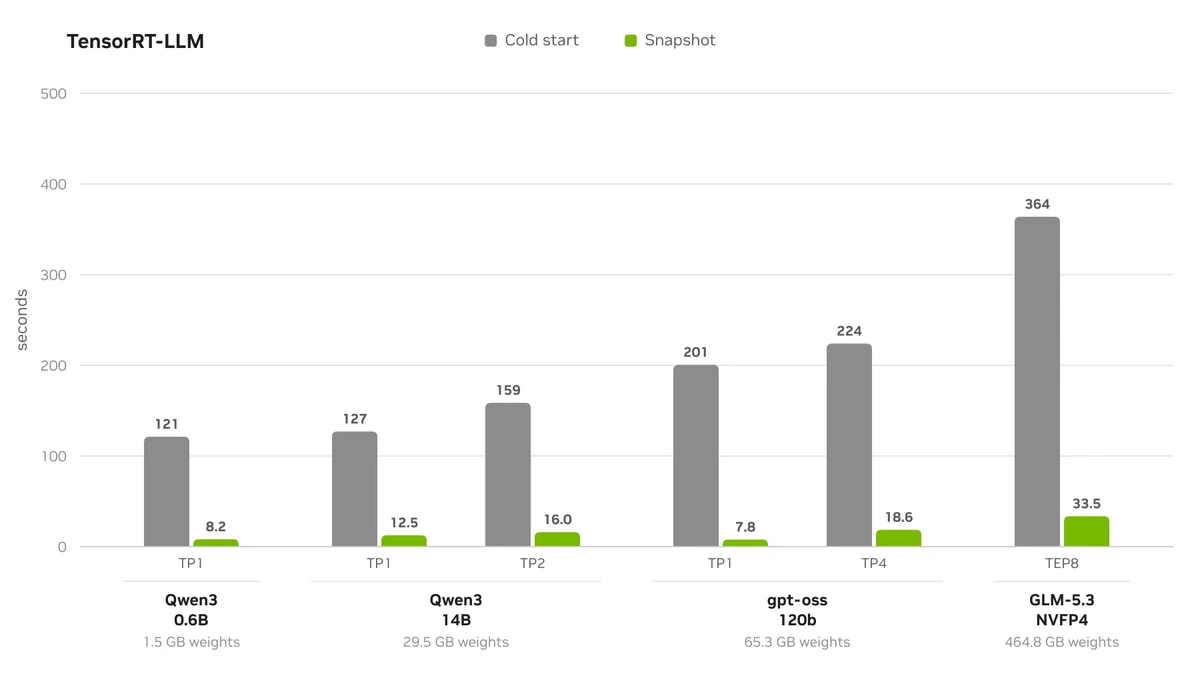
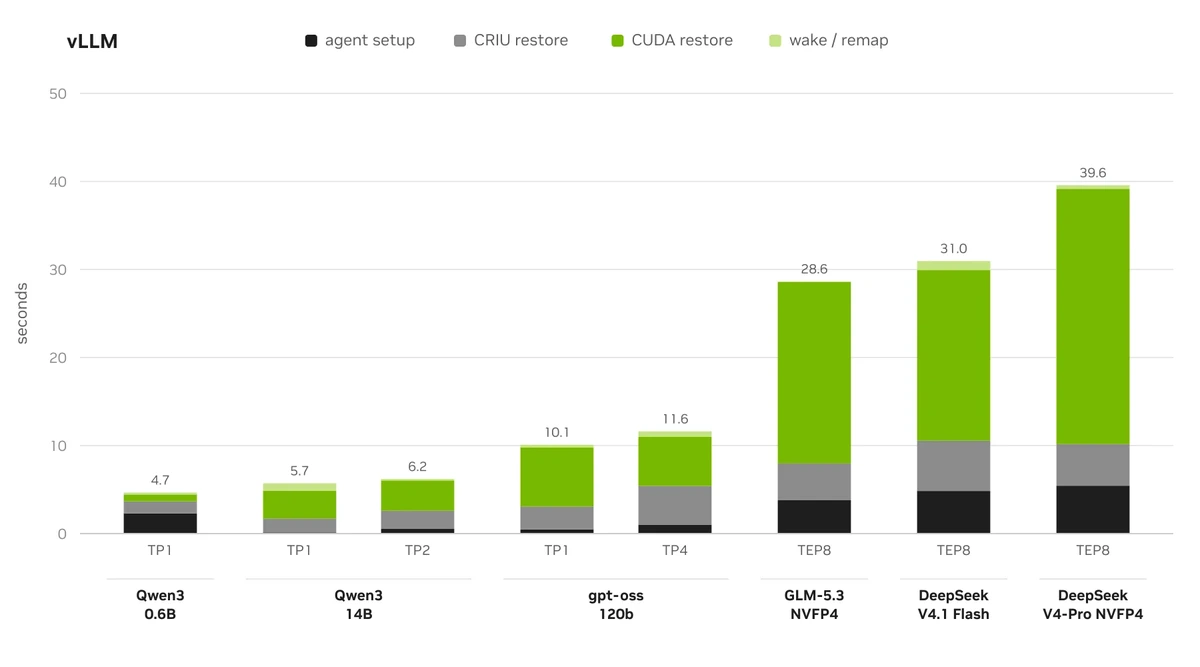
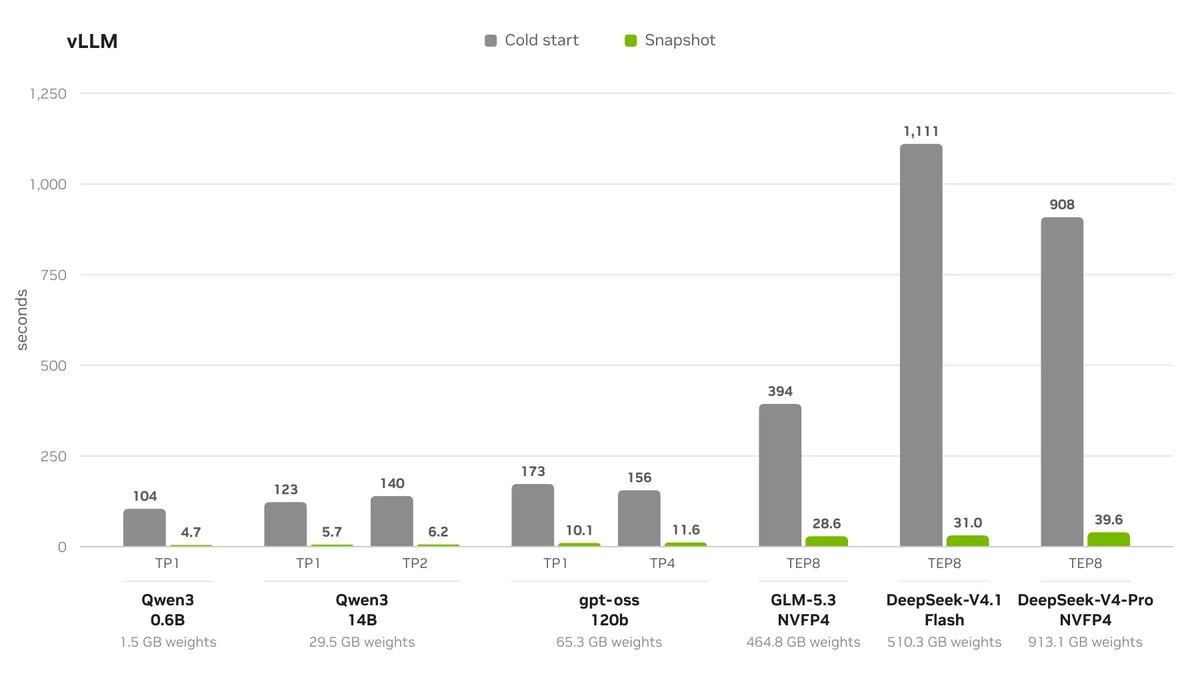
Los benchmarks abarcan modelos desde 600 millones de parámetros hasta modelos MoE con puntos de control de 1 TB en 8 GPU; las pruebas se realizaron sobre el mismo hardware y la misma pila de software con dos estrategias: arranque en frío frente a restauración con Snapshot. En todas las configuraciones probadas, Snapshot devuelve una réplica al servicio en menos de 45 segundos, entre 8 y 36 veces más rápido que un arranque en frío. Por motor, los rangos de restauración son los siguientes: vLLM, de 4,7 a 39,6 segundos; SGLang, de 3,6 a 42,7 segundos; TensorRT LLM, de 7,79 a 33,55 segundos. Ambas mediciones excluyen la descarga de la imagen del contenedor y la configuración del entorno de ejecución del contenedor, y la liberación de la caché KV se activa antes de cada punto de control, por lo que no forma parte del artefacto. El tiempo de creación del punto de control y el tamaño del artefacto se indican como un coste único por modelo y configuración.
La propia ruta de restauración consta de la configuración del agente, la restauración con CRIU, la restauración de CUDA y el despertar con reasignación, y el desglose del arranque en frío muestra qué fases de inicialización omite una restauración. Snapshot se desarrolló originalmente para los workers de inferencia de NVIDIA Dynamo, pero está diseñado para que lo integren otros motores de inferencia, planificadores, controladores y plataformas. Las herramientas de benchmarking y las instrucciones de reproducción están en el repositorio, junto con las instrucciones de instalación y las guías de uso, y una guía de usuario de Dynamo describe la restauración de workers. Los socios de diseño también han evaluado Snapshot con sus propias cargas de trabajo.