La plataforma NVIDIA Minerva AIOps conecta la telemetría de las fábricas de IA para maximizar la eficiencia de las GPU
 Public
- 26 Oct, 2026
Las fábricas de IA son algunos de los entornos operativos más complejos jamás construidos, donde cientos de miles de GPU, redes NVIDIA Spectrum-X Ethernet, redes de escalado vertical NVLink y planificadores distribuidos funcionan en perfecta sincronía continua. En el entrenamiento distribuido síncrono, todo el trabajo avanza al ritmo de su rango más lento, lo que significa que una sola GPU, interfaz o ruta de conmutador degradada puede desperdiciar tiempo útil en muchos recursos sanos. Los fallos que reducen el rendimiento suelen ser sutiles: por ejemplo, una GPU que funciona algo más caliente que las demás, un dispositivo NVMe que pierde rendimiento bajo carga sostenida o un conmutador que genera tormentas de tramas de pausa. Por separado, estas señales rara vez superan los umbrales estáticos, pero en conjunto provocan rezagados, aumentan los tiempos de paso y retrasan los puntos de control, lo que conlleva pérdidas de producción significativas.
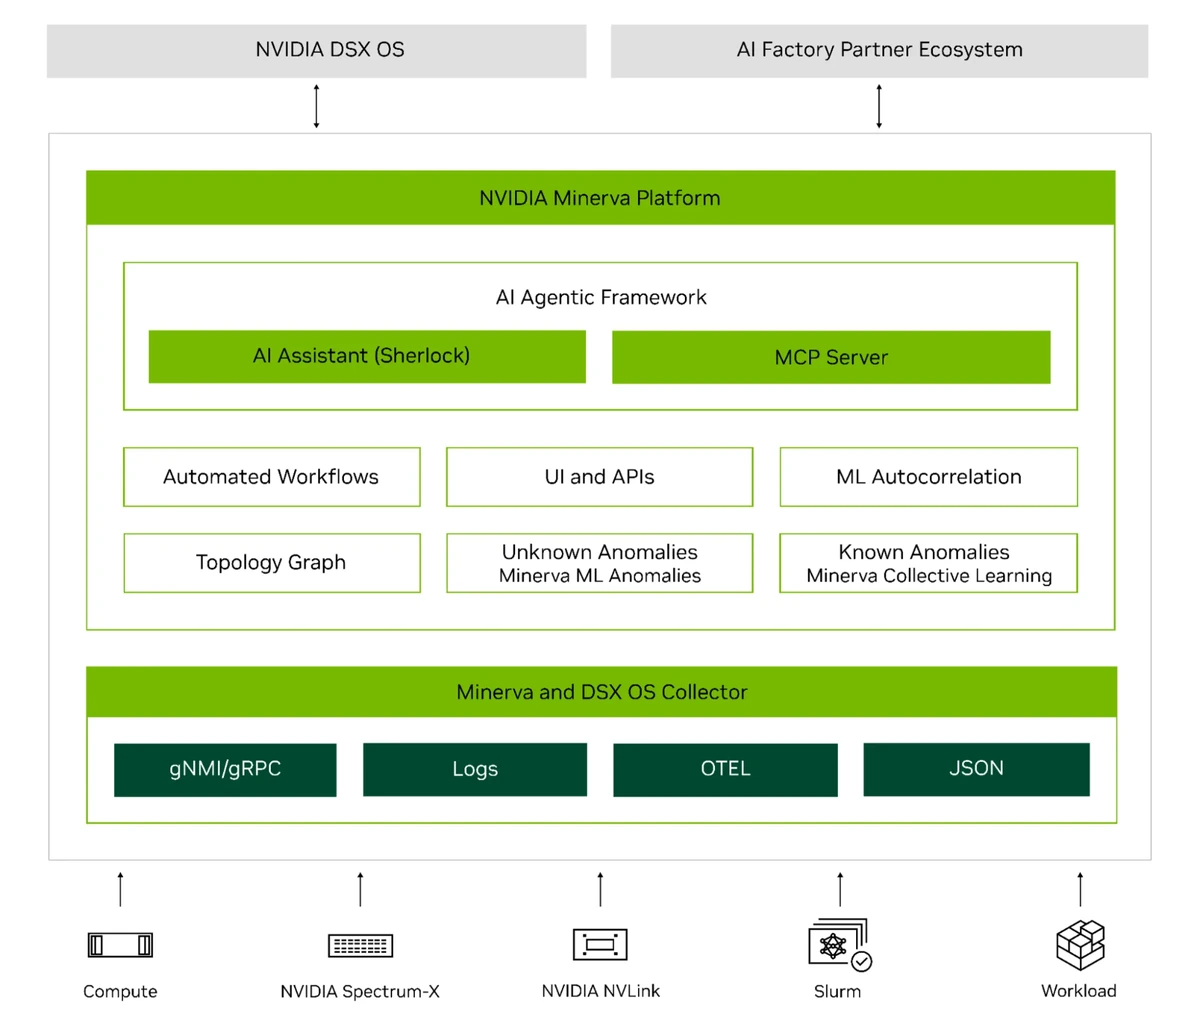
La diagnóstico se complica porque las evidencias están repartidas entre distintos equipos: los operadores de red ven los contadores de las interfaces, los operadores de cómputo ven el estado de los nodos y los equipos de ML ven los cambios en los tiempos de paso. Esta fragmentación convierte el triaje en una cadena de búsquedas en paneles y traspasos entre equipos, lo que puede transformar un fallo localizado en días de producción perdida. NVIDIA Minerva cubre estas carencias recopilando telemetría de toda la pila y asignando la infraestructura a los trabajos activos en un grafo de conocimiento dinámico. Aplica aprendizaje automático diseñado específicamente para correlacionar síntomas dependientes en incidentes de alta fidelidad. Un asistente basado en agentes de IA y un servidor MCP conectado a herramientas agénticas externas ofrecen una vía conversacional a través de esta evidencia en vivo, con el objetivo principal de preservar las horas de GPU efectivas y mantener el entrenamiento de los modelos avanzando sin interrupciones.
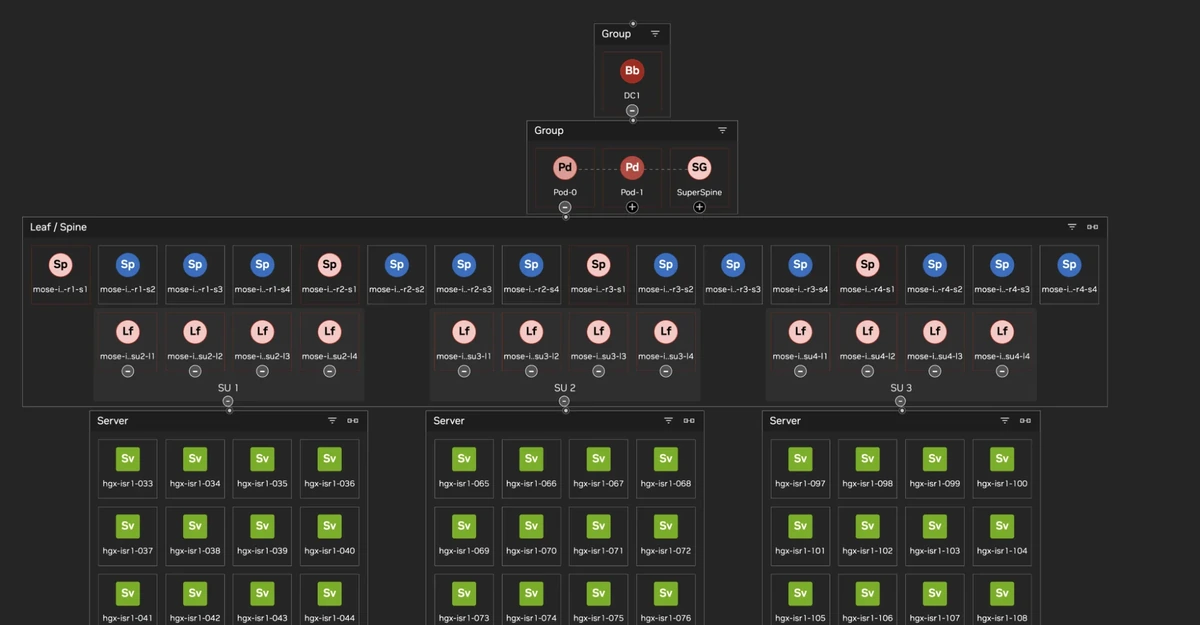
La supervisión basada en reglas tiene dificultades con los «fallos grises», en los que los componentes siguen disponibles pero presentan problemas solo bajo carga o en comparación con sus pares. Los umbrales absolutos suelen pasar por alto estos cambios, mientras que los umbrales agresivos generan ruido durante los cambios normales de carga de trabajo. La escala amplifica este problema, ya que un único fallo físico puede producir errores de interfaz, indicadores de congestión y cambios en el uso de la GPU que aparecen como eventos no relacionados en paneles distintos. Minerva ingiere métricas, registros y topología de GPU, conmutadores Spectrum-X y NVLink, SuperNIC, DPU, almacenamiento, NCCL y planificadores. El autodescubrimiento aporta las relaciones que la telemetría en bruto no tiene, y crea un grafo de conocimiento que representa los elementos de la infraestructura, del planificador y de las cargas de trabajo. Este grafo se actualiza dinámicamente a medida que los trabajos se inician o se detienen, o que se sustituyen nodos, y permite navegar desde una vista de toda la fábrica hasta una interfaz individual.
El grafo de topología transforma la ruta de investigación al permitir que los operadores rastreen anomalías desde una interfaz hasta su nodo, la ruta en la red y la ubicación actual del trabajo. A la inversa, los ingenieros de ML pueden seguir el ID de un trabajo a través de la evidencia de GPU, host, NIC y switch. Minerva procesa miles de millones de puntos de datos de métricas y registros por hora mediante modelos supervisados y no supervisados. La detección supervisada identifica patrones de error críticos conocidos y los asocia con recomendaciones de remediación, mientras que los modelos no supervisados aprenden los patrones normales de componentes de hardware o lógicos y los comparan con sus pares relevantes. La comparación con pares es fundamental, porque una medición puede parecer aceptable de forma aislada pero anómala en contexto, por ejemplo, una temperatura de GPU dentro de la especificación pero notablemente más alta que la de las GPU vecinas bajo la misma carga. Los modelos multivariantes combinan temperatura, potencia, frecuencias y utilización para detectar la degradación antes del fallo total.
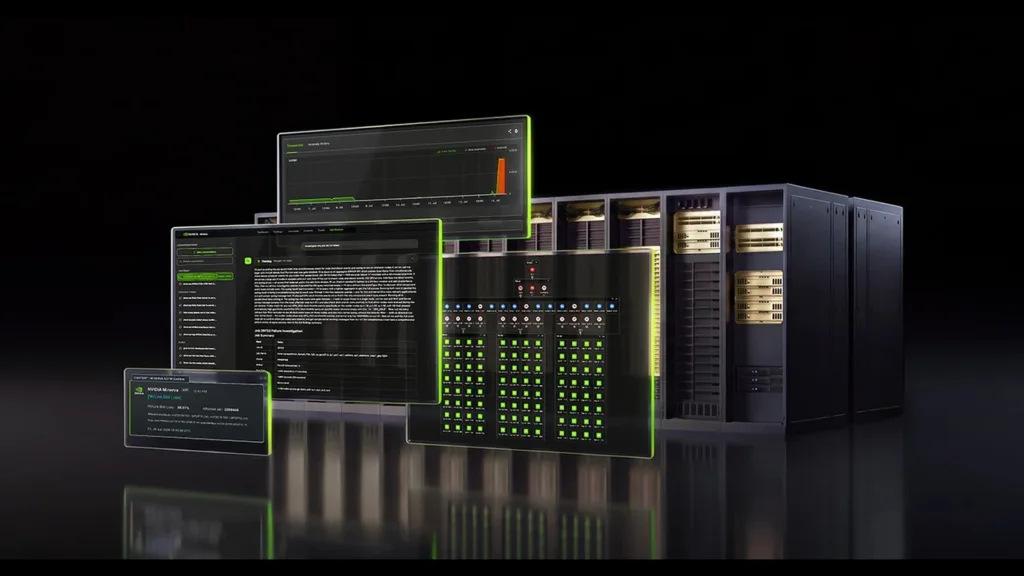
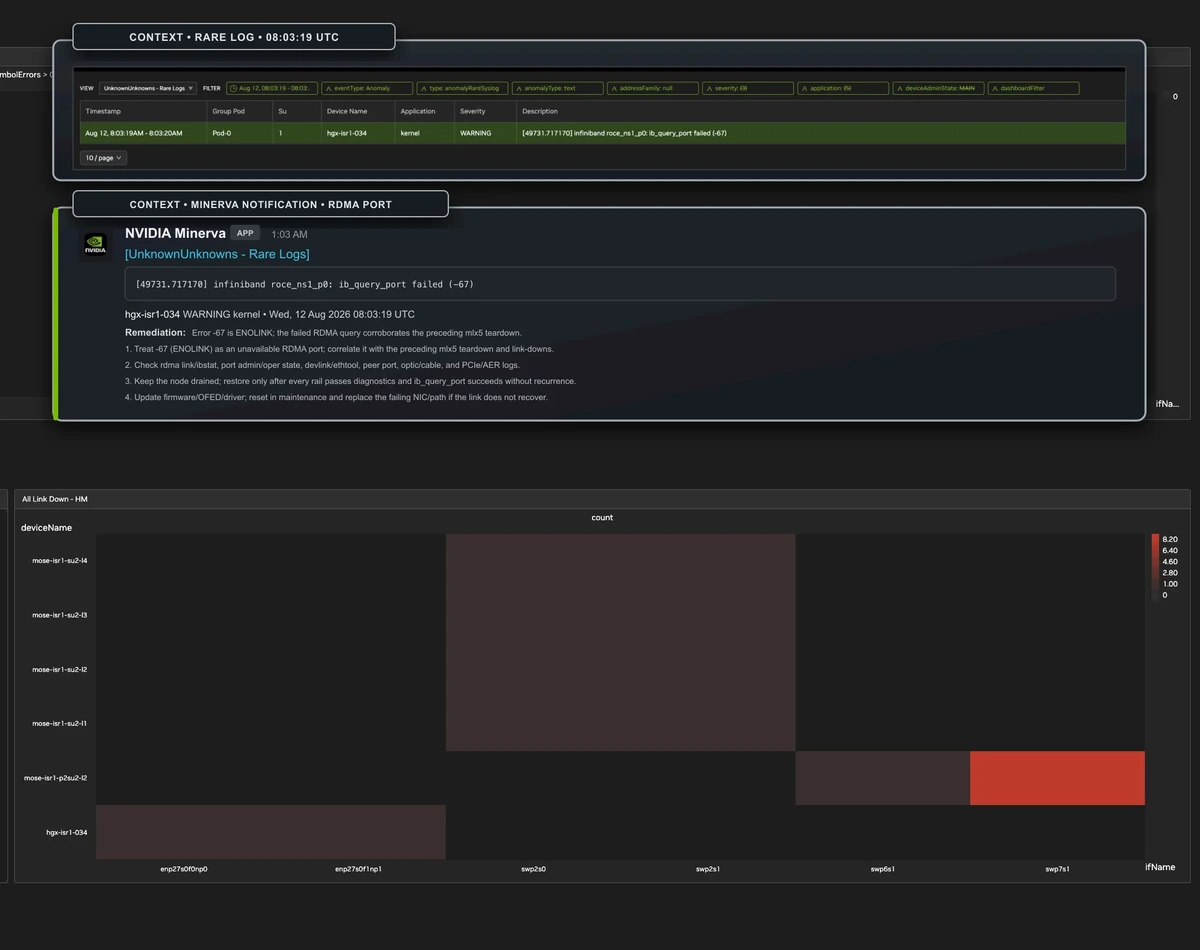
Los registros reciben un tratamiento similar: la detección de anomalías basada en NLP descubre patrones nunca vistos, y la coincidencia supervisada identifica errores críticos conocidos. Las detecciones pueden alimentar los flujos de trabajo del planificador para drenar los nodos afectados antes de que se les asignen nuevos trabajos, o en intervalos seguros de puntos de control. La correlación con conocimiento de la topología conecta la detección con la acción del operador, usando el grafo de conocimiento para determinar qué eventos comparten una ruta de dependencia. Los síntomas derivados se agrupan en un único incidente en lugar de competir por la atención, de modo que los eventos redundantes y las series de métricas relacionadas se reducen a una sola señal con la topología y las cargas de trabajo afectadas adjuntas. Las pruebas de NVIDIA muestran reducciones significativas en el número de eventos notificados y de tickets en los escenarios compatibles, lo que permite a los operadores empezar con un espacio de búsqueda mucho menor para el análisis de la causa raíz.
NVIDIA Minerva incluye un agente de IA nativo llamado Sherlock, basado en telemetría en vivo y en el grafo de conocimiento, que permite a los operadores consultar el sistema para el análisis de la causa raíz en lenguaje natural. Sherlock puede presentar evidencias de apoyo y recomendar medidas de remediación sin exigir que los operadores conozcan métricas concretas ni lenguajes de consulta, lo que ofrece un acceso al conocimiento especializado que tradicionalmente requería escalar a especialistas. Además, el servidor MCP de Minerva permite que herramientas agénticas externas consulten el mismo contexto operativo, de modo que los equipos puedan incorporar datos en vivo de la fábrica de IA a sus propios flujos de trabajo. Las acciones de mitigación pueden seguir siendo aprobadas por una persona o automatizarse según la política local y la evaluación de riesgos. En un gran centro de datos de IA, Minerva identificó una única conexión NVLink, entre 400 000 interfaces, que perdía ancho de banda, lo que permitió a un SRE drenar los nodos afectados y restablecer la velocidad completa en minutos en lugar de horas.