NVIDIA incorpora agentes de IA para automatizar las operaciones de las fábricas de IA y reducir la carga de los SRE
 Public
- 05 Nov, 2026
A medida que crecen los clústeres de GPU, los ingenieros de fiabilidad de sitios (SRE) se enfrentan al desafío de correlacionar las caídas de rendimiento entre las capas de cómputo, red y hardware. NVIDIA desarrolló AI Factory Operations Agent para optimizar las operaciones internas de DGX SuperPOD y reducir el trabajo manual. El sistema utiliza agentes especializados que detectan fallos, identifican sus causas raíz y ofrecen recomendaciones mediante una interfaz de chat. Los ingenieros pueden interactuar con estos agentes en lenguaje natural, cambiar entre investigaciones y hacer un seguimiento de las acciones para fines de auditoría, lo que evita tener que revisar manualmente numerosos paneles.
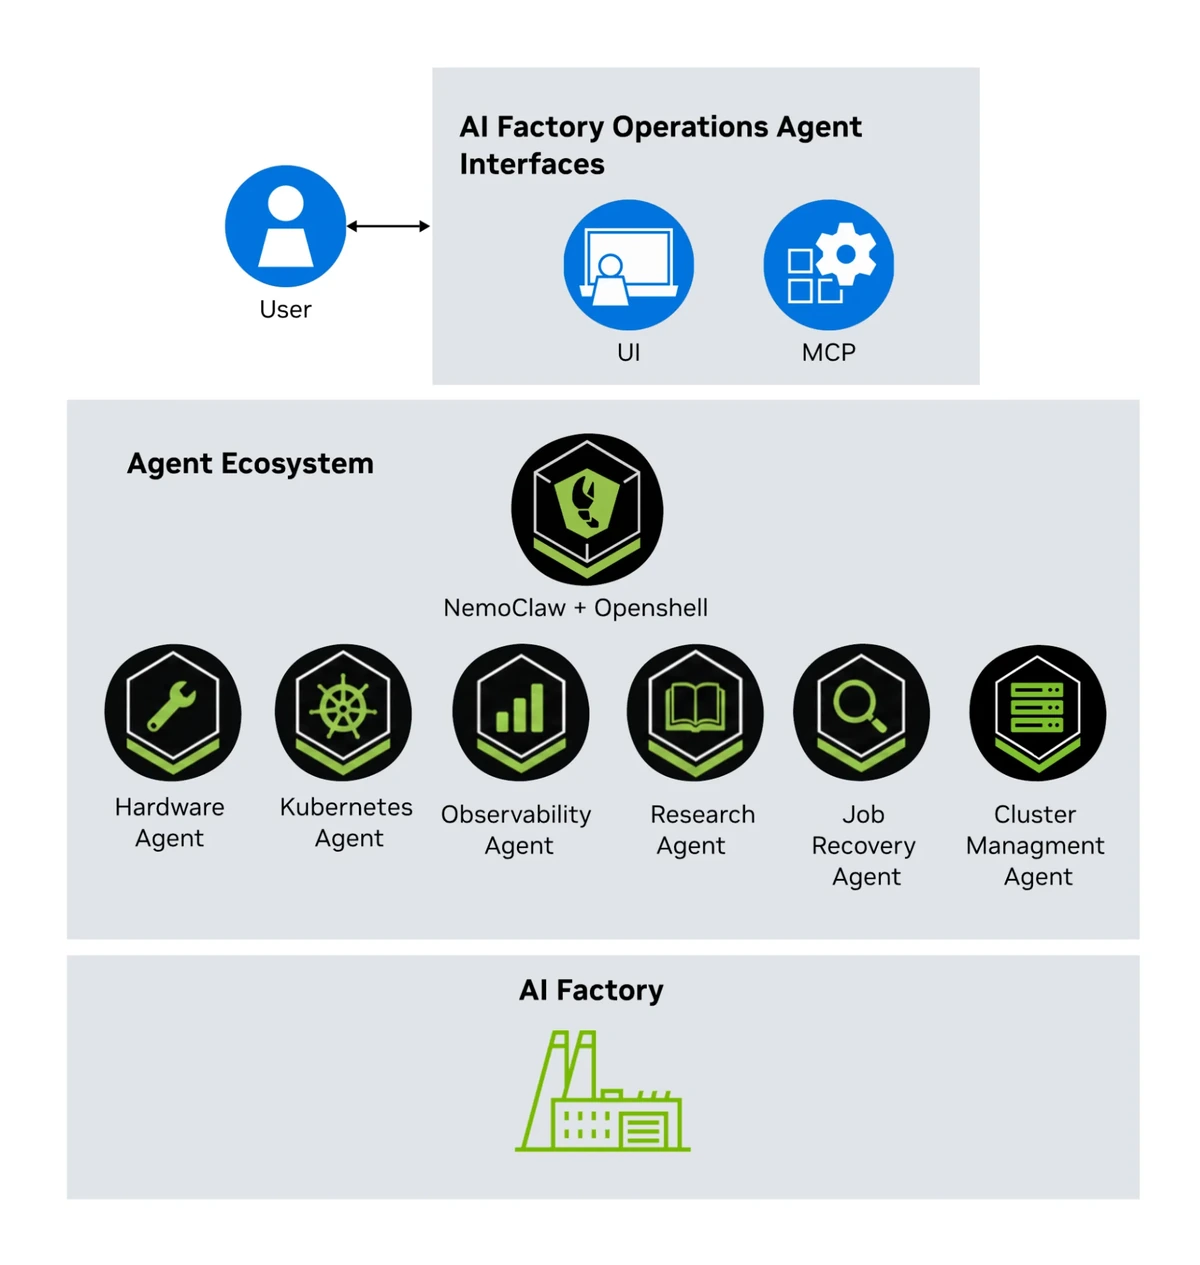
El ejemplo para desarrolladores está construido sobre el blueprint NVIDIA NemoClaw e incluye un entorno de ejecución de agentes orientado al usuario, que dirige las consultas a agentes de dominio. La conectividad se establece mediante plugins de OpenClaw y servidores de Model Context Protocol, que ofrecen acceso a herramientas operativas muy específicas. El framework utiliza NVIDIA OpenShell y admite un despliegue totalmente local para garantizar la soberanía de los datos. La inferencia se basa en modelos abiertos NVIDIA Nemotron servidos localmente, que se ejecutan en clústeres de producción DGX H100, B200 y GB300. Esta arquitectura modular permite añadir nuevos agentes e integraciones con la infraestructura sin modificar los componentes existentes.
El despliegue se realiza como una aplicación de Kubernetes control-plane, donde Helm gestiona la UI, la pasarela de OpenClaw, los servidores MCP y los puntos de acceso para la inferencia. Para ejecutar comandos en la shell, OpenShell crea sandboxes de Kubernetes aislados para cada sesión, separando los comandos del pod principal de la pasarela y garantizando que el entorno de ejecución no modifique las cargas de trabajo de producción. La seguridad se aplica mediante un control de acceso por niveles. La herramienta del lado del servidor run_kubectl utiliza binarios fijados y credenciales de solo lectura, mientras que el RBAC de Kubernetes define los recursos que se pueden consultar. Esta configuración permite a los agentes comprobar sus permisos, por ejemplo, confirmando que pueden obtener la lista de pods, pero no de secretos, ni crear nuevos pods.
El despliegue interno utiliza un conjunto de agentes de dominio. Job Recovery Agent analiza los fallos de entrenamiento en los niveles del planificador y del hardware. Hardware Agent diagnostica fallos a nivel de dispositivo, como errores de PCIe y anomalías térmicas. Observability Agent consulta datos de Prometheus y Grafana Loki para generar dashboards dinámicos. Research Agent busca información en la documentación precargada, y Kubernetes Agent ofrece acceso de solo lectura al estado del clúster. Cluster Management Agent interactúa con las API de Base Command Manager. Las herramientas transversales incluyen búsqueda web y ejecución de código, y el framework admite servidores MCP personalizados para necesidades operativas específicas.
NVIDIA recomienda un plano de control dedicado y acelerado por GPU, aislado del clúster de producción, para gestionar la orquestación de agentes sin consumir los recursos necesarios para el entrenamiento. En entornos multiusuario, OpenShell refuerza los límites ejecutando los agentes en entornos aislados (sandboxes) con restricciones a nivel de kernel, lo que garantiza que los SRE de cada inquilino solo accedan a sus propios espacios de nombres y nodos. El framework está disponible como software experimental de código abierto en GitHub, aunque las API y las configuraciones pueden cambiar entre versiones. Los clientes de NVIDIA pueden ponerse en contacto con sus gestores de cuenta para solicitar acceso a los agentes propietarios de operaciones de clústeres desarrollados para uso interno.