NVIDIA AICR confirma la compatibilidad de Kubernetes con Vera Rubin NVL72
 Public
- 03 Nov, 2026
Configurar Kubernetes para nuevo hardware de GPU, como NVIDIA Vera Rubin, es una tarea compleja y propensa a errores, que exige una alineación precisa de controladores, kernels, runtimes y planificadores. NVIDIA AI Cluster Runtime (AICR), parte de la plataforma DSX AI Factory, simplifica este proceso al guardar configuraciones optimizadas en forma de recetas reutilizables. Genera paquetes para herramientas de despliegue y valida los clústeres en funcionamiento, lo que garantiza que los entornos estén listos para los módulos de cómputo Vera Rubin NVL72 desde el primer día. Este enfoque ayuda a los equipos de plataforma a diseñar, construir y operar fábricas de IA eficientes con componentes de software modulares y de código abierto.
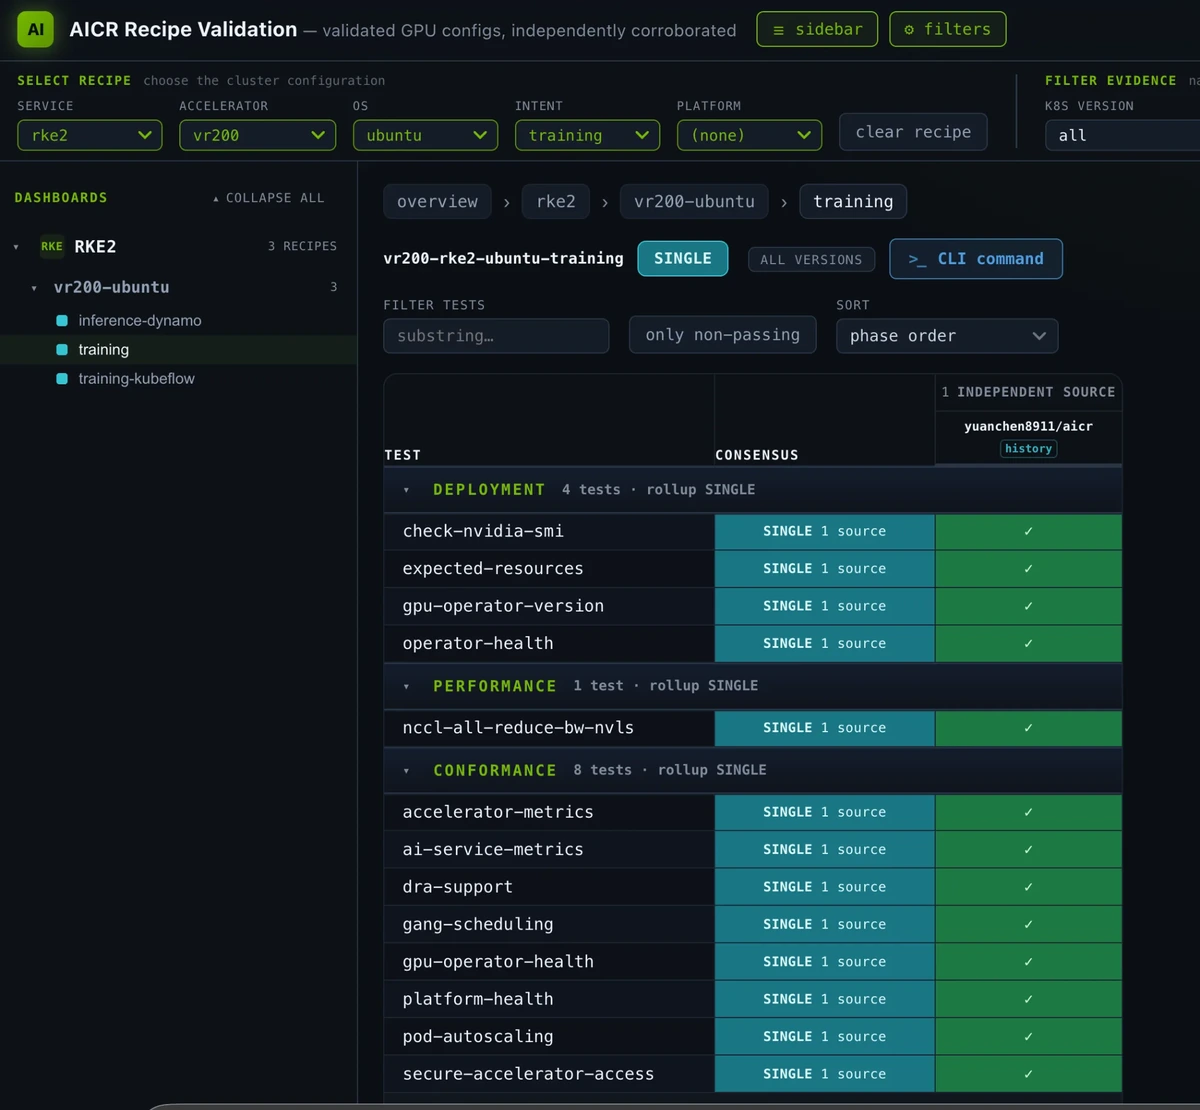
Para los equipos que actualmente utilizan GB200 NVL72, Vera Rubin NVL72 es la tercera generación de la arquitectura de rack MGX, con varios cambios visibles para los usuarios. Para validar la compatibilidad de extremo a extremo, el paquete de runtime de AICR se desplegó en clústeres Vera Rubin con GPU Operator v26.7.0, el controlador DRA v0.5.0 y el controlador R615 instalado en el host. Ambas variantes de las recetas, la de entrenamiento y la de inferencia, superaron con éxito la validación de extremo a extremo. La variante de entrenamiento incluye un umbral de control de rendimiento: un NCCL all-reduce entre nodos a través de la red NVLink mediante un IMEX ComputeDomain, limitado por un umbral mínimo de ancho de banda del bus. En las primeras etapas de la validación surgió un problema temporal de hardware o de red en uno de los clústeres, pero la reinstalación del hardware lo resolvió y permitió que todas las GPU se unieran en un único grupo de red.
AICR registra las decisiones específicas de la plataforma en forma de una receta versionada, lo que hace que las configuraciones sean explícitas y reproducibles. La nueva familia de recetas para Vera Rubin (servicio: rke2, acelerador: vr200, SO: Ubuntu) se ofrece en estado Preview, sin soporte completo para producción mientras la plataforma se encuentra en fase previa al lanzamiento. El primer despliegue se dirigió a una combinación novedosa: arm64, Ubuntu 26.04, un kernel con páginas de 64 KB, RKE2 y Vera Rubin, y permitió obtener un runtime operativo en cuestión de horas. Un segundo clúster reprodujo este resultado al día siguiente, lo que demuestra la repetibilidad de la receta. Este enfoque con versionado garantiza que las decisiones concretas adoptadas durante el proceso de puesta en marcha se conserven y puedan verificarse en distintos clústeres.
El flujo de trabajo de AICR, ejecutado con la cadena de herramientas v1.0.0, comienza con la generación de la receta sin conexión. El comando aicr recipe resuelve los criterios contra el catálogo y genera un archivo YAML que superpone cinco overlays en 14 componentes. Los componentes clave incluyen GPU Operator, el controlador DRA, DraNet para la asignación de dispositivos ConnectX-9 y NodeWright para el modo exclusivo de RDMA netns. El comando de generación del paquete aicr bundle crea un conjunto de charts de Helm ordenados y un script de despliegue. Este paquete incluye NodeWright, KAI Scheduler, NVSentinel, NFD y la pila de Prometheus, y las versiones de todos los componentes están fijadas según la configuración validada en el hardware Vera Rubin.
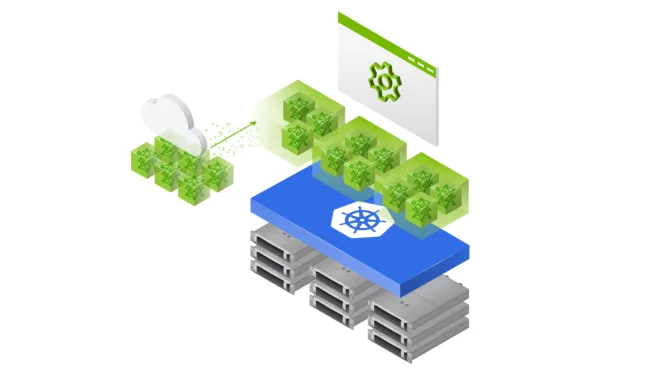
La validación consiste en capturar el estado del clúster y comprobar las condiciones de preparación. El comando aicr snapshot guarda el estado, mientras que aicr validate ejecuta las fases de despliegue, conformidad y rendimiento. La fase de despliegue comprueba la versión del sistema operativo y los detalles del kernel, y la fase de conformidad verifica la salud de los componentes. La fase de rendimiento ejecuta un NCCL all-reduce como tarea dentro del clúster, comprobando el ancho de banda del bus frente al umbral mínimo de la receta. El validador aprovisiona por sí mismo el ComputeDomain y el IMEX ResourceClaimTemplate, sin requerir acciones previas por parte del operador. La variante para inferencia, que utiliza la plataforma Dynamo, supera las mismas comprobaciones de despliegue y conformidad en el mismo clúster.
Una prueba crítica de extremo a extremo consiste en un ComputeDomain de dos nodos, donde los pods reclaman los canales IMEX en cada bandeja de cómputo. Para las imágenes con IMEX gestionado por el host, el servicio estático nvidia-imex del host debe estar deshabilitado y enmascarado, ya que es incompatible con los ComputeDomains gestionados por DRA. GPU Operator v26.7.0 y posteriores incluye un CRD más estricto que exige establecer explícitamente numNodes, lo que afecta a las instalaciones nuevas de clústeres, pero no a las actualizaciones. Al aplicar el manifiesto de prueba se inician dos pods, y en cada uno se inyecta un canal IMEX, lo que tarda unos 12 segundos. Toda la secuencia, desde la generación de la receta hasta la validación, se completa en aproximadamente cinco minutos, y la fase de rendimiento añade el tiempo de ejecución del trabajo de NCCL.