Límites de memoria de GPU por carga de trabajo en Kubernetes con CUDA 13.4 y KAI Scheduler
 Public
- 28 Oct, 2026
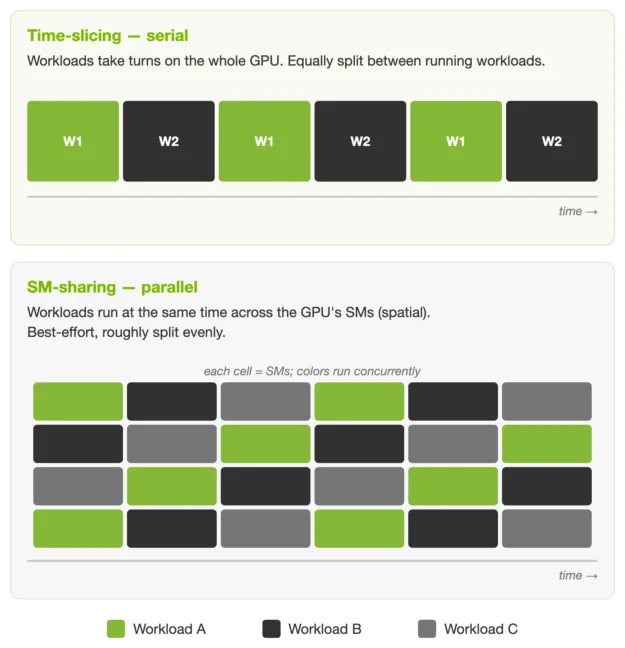
Las cargas de trabajo de IA suelen requerir solo una parte de una GPU, pero asignar dispositivos completos genera capacidad ociosa y un uso ineficiente de la infraestructura. Las GPU de NVIDIA admiten varios mecanismos de uso compartido: Multi-instance GPU (MIG) para aislamiento por hardware, time-slicing para la ejecución secuencial de procesos y Multi-Process Service (MPS) para la ejecución simultánea en espacios de direcciones independientes. Aunque MPS permite compartir recursos de cómputo, antes carecía de límites de memoria estrictos. CUDA 13.4 cubre esta carencia con un nuevo modo time-sharing, que limita la memoria de forma transparente para la aplicación y garantiza que cada carga de trabajo opere dentro de los límites definidos, sin necesidad de modificar el código.
La implementación de estas capacidades en un clúster de Kubernetes requiere una coordinación a nivel de nodo independiente del planificador. El operador de código abierto gpu-fractioning, alojado en la organización KAI Scheduler en GitHub, se ejecuta junto con NVIDIA GPU Operator para encargarse de esta configuración. Cumple tres funciones críticas: lee las anotaciones de los pods para determinar los requisitos de memoria y de cómputo, configura las GPU asignadas para aplicar estos límites y gestiona la transición entre los distintos modos de uso compartido. Este operador garantiza que el hardware respete los límites lógicos definidos por el planificador del clúster, tendiendo un puente entre las decisiones de planificación de alto nivel y la ejecución de bajo nivel en la GPU.
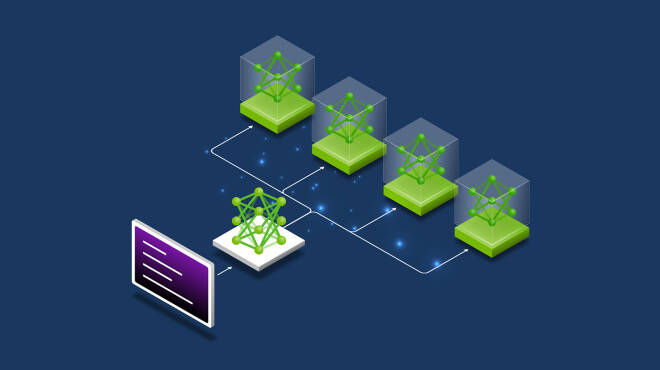
El flujo de trabajo comienza cuando los desarrolladores especifican los requisitos de recursos y los modos mediante anotaciones YAML de los pods. Después, el planificador selecciona las GPU adecuadas, registra la asignación de memoria y el modo de uso compartido del cómputo en las anotaciones del pod de cada contenedor y asigna la carga de trabajo. El operador gpu-fractioning lee estas anotaciones y configura las GPU en consecuencia. Cualquier planificador de Kubernetes capaz de escribir estas anotaciones puede aplicar fracciones de GPU, siempre que cumpla dos reglas: seleccionar GPU con suficiente memoria libre y evitar mezclar modos de cómputo en un mismo dispositivo. KAI Scheduler es el primero en integrar esta función, e introduce un modo de uso compartido de GPU llamado NvFractions a partir de la versión v0.18.0.
El modo NvFractions de KAI Scheduler permite a los administradores definir cargas de trabajo fraccionarias mediante cuatro anotaciones clave que regulan las solicitudes de memoria, los límites de crecimiento, los modos de uso compartido del cómputo y el número de dispositivos. Las solicitudes de memoria pueden especificarse como tamaños absolutos con las unidades estándar de Kubernetes o como fracciones de una GPU con la anotación gpu-fraction. Una nueva capacidad permite que las cargas de trabajo declaren una solicitud mínima garantizada y un límite máximo de ráfaga, que es opcional y, si se omite, toma por defecto el valor de la solicitud. Los límites de fracción deben ser superiores a gpu-fraction e inferiores a 1. El uso compartido del cómputo ahora es explícito y se define por contenedor, lo que permite elegir entre sm-sharing y time-slicing.
Una GPU compartida funciona en un solo modo de cómputo a la vez, por lo que KAI Scheduler impide colocar en la misma GPU cargas de trabajo con modos distintos, aunque un mismo nodo puede alojar ambos modos en dispositivos diferentes. En configuraciones con varias GPU, la anotación gpu-fraction-num-devices indica cuántos dispositivos abarca la carga de trabajo, y la solicitud de memoria se aplica a cada dispositivo de forma individual. Por ejemplo, una solicitud de 40Gi con cuatro dispositivos asigna 40Gi en cada GPU. Esta configuración es ideal para servidores de inferencia que necesitan memoria garantizada en cada GPU y pueden usar ráfagas cuando los vecinos están inactivos, con sm-sharing para cargas de trabajo de confianza que se ejecutan de forma concurrente en un único dominio de errores.
Por el contrario, time-slicing es adecuado para tareas de desarrollo o por lotes, como notebooks y pequeñas ejecuciones de ajuste fino, donde se prefiere el aislamiento. En este modo, cada carga de trabajo obtiene su propio dominio de errores, lo que significa que un fallo en una tarea no afecta a las demás. Una carga de trabajo puede solicitar la mitad de dos GPU con un límite de crecimiento de hasta el 80 % cuando haya memoria disponible. Al ejecutar nvidia-smi dentro del contenedor se mostrará la fracción de memoria asignada a cada GPU. Tanto KAI Scheduler como el operador gpu-fractioning están disponibles en GitHub, en la organización KAI Scheduler, con guías detalladas de instalación y configuración para todos los mecanismos de uso compartido.