Daviator acelera VASP en las GPU de NVIDIA: cálculo por lotes de puntos k y precisión mixta
 Public
- 18 Nov, 2026
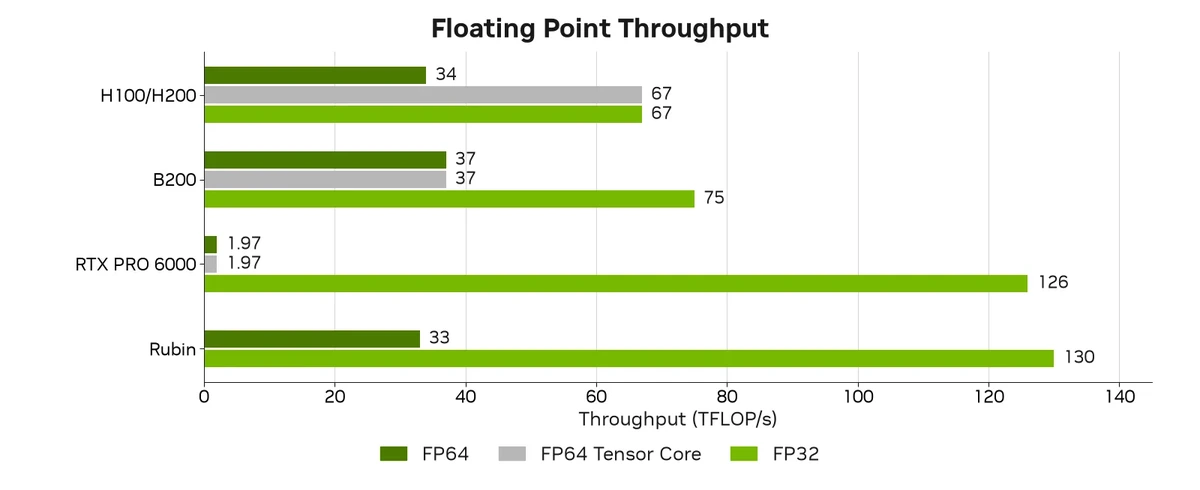
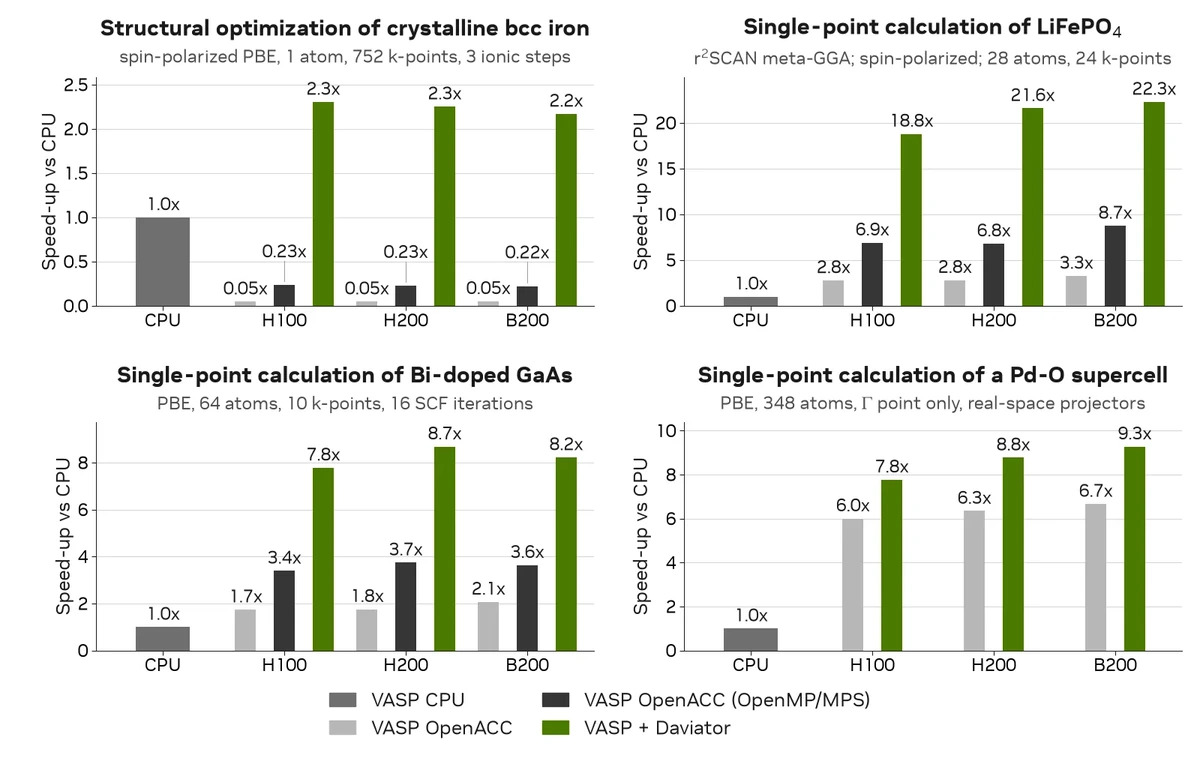
Para entrenar potenciales interatómicos de aprendizaje automático (MLIP) se necesitan decenas y cientos de millones de cálculos DFT de energías, fuerzas y tensiones. Lo más habitual es obtenerlos con VASP, el principal código DFT de ondas planas. En estas tareas suelen usarse celdas unitarias pequeñas y mallas densas de puntos k, y las GPU quedan infrautilizadas. El port de VASP a OpenACC procesa los puntos k de forma secuencial, por lo que en los sistemas pequeños cada paso lanza cientos de kernels diminutos y la sobrecarga de lanzamiento se come todo el tiempo. Un sistema de un solo átomo de hierro con 752 puntos k se calculaba en la GPU 8 veces más lento que en la CPU, y los investigadores tenían que repartir las tareas a mano según su tamaño. Además, el FP64 está estancado: el rendimiento en FP64 de Hopper, Blackwell y Rubin no crece, mientras que el FP32 sigue aumentando. La RTX PRO 6000 tiene una relación FP32:FP64 de 64:1.
Daviator es una biblioteca de kernels de GPU de NVIDIA que sustituye los bucles por punto k por operaciones por lotes. Su base es un solucionador de Davidson por lotes que usa FFT por lotes, GEMM por lotes y kernels propios. Al haber menos lanzamientos, la ocupación de los SM se acerca a la saturación, y los datos permanecen en la memoria de la GPU. VASP conserva el bucle SCF, la mezcla, la simetría y la entrada/salida, mientras que Daviator se conecta en límites de llamada bien definidos. Se activa mediante el microservicio NVIDIA ALCHEMI VASP con el parámetro LDAVIATOR=True en INCAR e intercepta el solucionador de Davidson (ALGO = Normal). No hace falta modificar los archivos de entrada existentes. El ejemplo usa un único átomo de Fe con ISPIN = 2, NBANDS = 12, PREC = Accurate y una malla de 30x30x30 centrada en el punto Gamma.
Algunos kernels están especializados para determinados tamaños de lote y pueden compilarse en el primer uso. Por eso, en los scripts de los trabajos conviene apuntar CUDA_CACHE_PATH a un almacenamiento rápido, como /tmp/cudacache, y no a $HOME, y establecer CUDA_CACHE_DISABLE=0. Los cálculos se lanzan como de costumbre, por ejemplo mpirun -np 1 vasp_std. Por ahora solo se admite un nodo; el modo multinodo, vasp_ncl y vasp_gam están previstos. Como referencia se tomó VASP 6.6.0 en CPU y con OpenACC en H100/H200 y B200. Un átomo de hierro se calcula más de 2 veces más rápido que en CPU. LiFePO4 con r2SCAN acelera el solucionador de Davidson 22 veces, y el GaAs dopado con Bi de 64 átomos reduce el tiempo de cálculo en más de un 85%. Incluso un sistema de 348 átomos con un solo punto k mejora, de modo que ya no hace falta clasificar los trabajos por tamaño. Según las estimaciones para conjuntos de datos, el tiempo hasta el resultado se reduce hasta 22 veces y el coste hasta un 75% en comparación con la CPU.
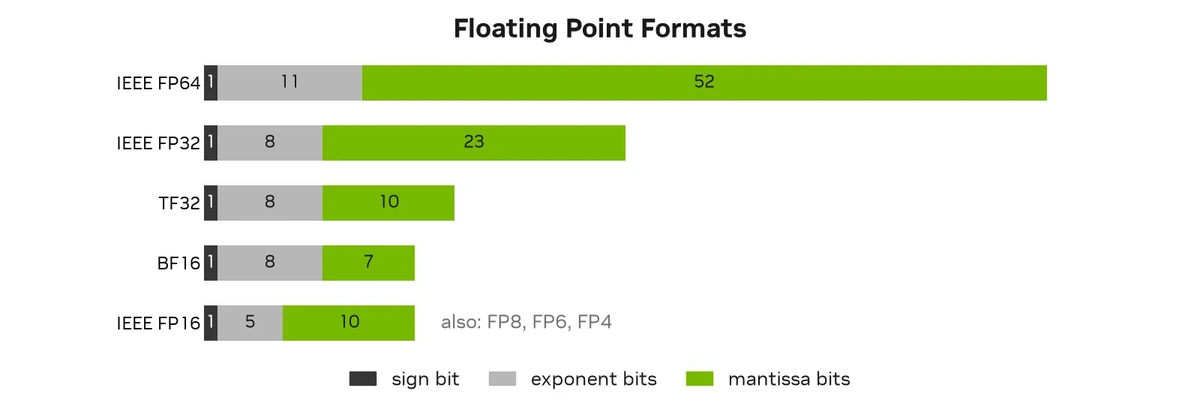
Daviator por lotes sigue calculando en FP64, y crear un solucionador de Davidson de precisión mixta no es sencillo. Si se pasan los kernels a FP32 y se compara el resultado con FP64, solo se obtiene «pasa» o «no pasa». Sin embargo, los fallos ocultos, como la deriva de la energía, una convergencia incorrecta o trayectorias de DM divergentes, pueden parecer perfectamente verosímiles. Por eso se usa un tipo genérico de coma flotante con número configurable de bits de mantisa y de exponente. Con él se determina la precisión mínima necesaria para cada kernel y se decide si pasarlo a FP32, reescribirlo o dejarlo como «isla» FP64. Los resultados dependen de los datos de entrada y del umbral. La instrumentación debe abarcar también las dependencias y las funciones matemáticas, y las ejecuciones instrumentadas, que son lentas, pueden paralelizarse en recursos de HPC. Se empieza con conversiones FP64↔FP32 alrededor de la ruta crítica y con kernels de tipo configurable, y después, iteración tras iteración, se reducen las regiones FP64.
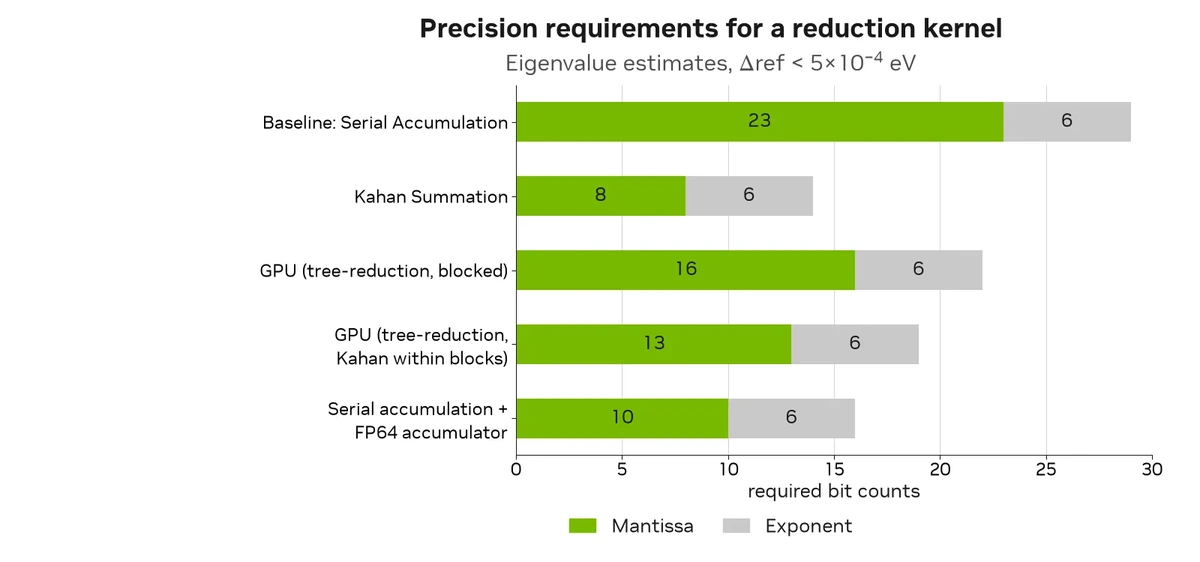
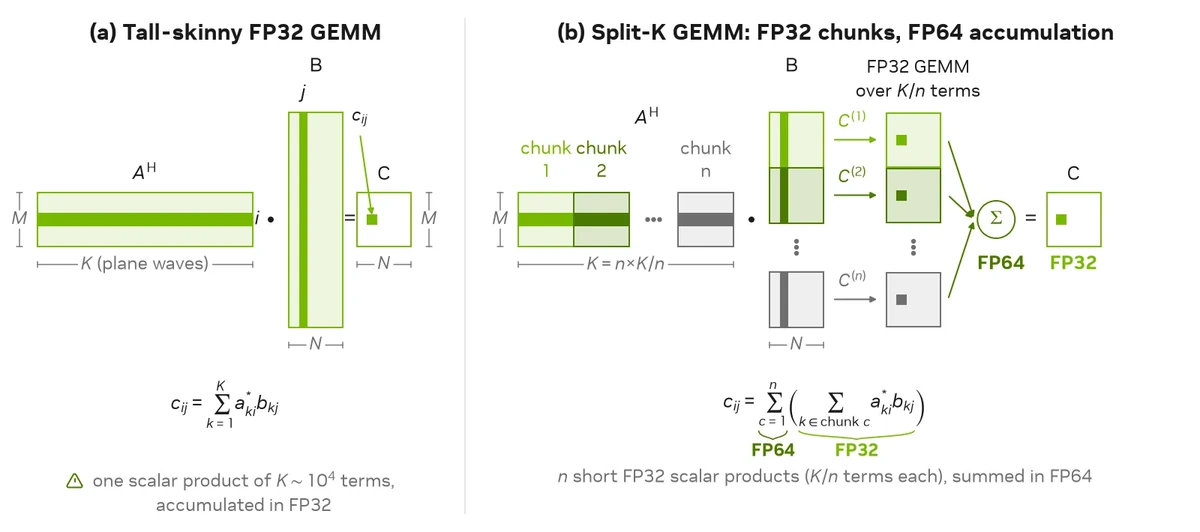
El análisis basado en Verificarlo mostró que las FFT, la aplicación del hamiltoniano y la actualización de los orbitales se pueden pasar a FP32. El problema de valores propios en el subespacio, las energías, los criterios de convergencia y los GEMM altos y estrechos con los que se construyen las matrices del subespacio se mantuvieron en FP64. Estos GEMM del método de Rayleigh-Ritz alimentan un solucionador de valores propios sensible, por lo que se aplica un algoritmo split-k: los productos escalares se calculan por bloques en FP32 y la suma final se realiza en FP64. El umbral EDIFF de VASP es por defecto de 10-4 eV y puede bajar hasta 10-6 eV o menos, mientras que FP32 ofrece unas 7 cifras significativas. El solucionador mixto converge hasta 10-4-10-6 eV según los datos de entrada, y por debajo del nivel de ruido de FP32 el cálculo continúa en FP64. En GaAsBi-64, FP32 da una aceleración de 2 veces con EDIFF = 10-5 eV, y la combinación FP32→FP64 con 10-8 eV funciona 1,5 veces más rápido que FP64 puro.
En H100 y H200, donde los Tensor Cores FP64 igualan a FP32 en rendimiento, la ganancia es pequeña. En cambio, en la RTX PRO 6000 el solucionador de Davidson en FP32 funciona de 3 a 7 veces más rápido, y el cálculo completo, aproximadamente 2 veces. La precisión mixta se activa con el parámetro LDAVIATOR_MIXED_PRECISION (0 significa FP64). Cada paso iónico comienza con almacenamiento en FP32 hasta alcanzar DAVIATOR_EDIFF_FP32 o DAVIATOR_SWITCH_TO_FP64_AFTER_STEP; para la mayoría de los datos de entrada sirve un valor de 10-4-10-5. El ejemplo establece EDIFF = 5e-07, LDAVIATOR = True, LDAVIATOR_MIXED_PRECISION = True, DAVIATOR_SWITCH_TO_FP64_AFTER_STEP = -2 y DAVIATOR_EDIFF_FP32 = 5e-05. Se necesita una licencia de VASP, y Daviator con precisión mixta funcionará en cualquier GPU de NVIDIA a través del microservicio ALCHEMI VASP.