CUDA Rust: ahora con dos vías para el desarrollo nativo de kernels de GPU en Rust
 Public
- 09 Sep, 2026
En septiembre de 2026, NVIDIA anunció que apuesta por la programación nativa de GPU en Rust. CUDA C++ y CUDA Python son toolchains maduros de nivel empresarial, pero la capa de sistemas de la IA (motores de inferencia, infraestructura de servicio, controladores y runtimes de agentes) cambia constantemente y se escribe cada vez más en Rust, que detecta clases enteras de errores en tiempo de compilación sin sacrificar rendimiento. La propia NVIDIA forma parte de ese cambio: el controlador Nova de Linux está escrito en Rust, NVIDIA Dynamo está construido sobre un núcleo en Rust y NVTX tiene bindings para Rust. El kernel de GPU era la excepción, ya que los kernels podían lanzarse desde Rust, pero normalmente había que escribirlos en otro lenguaje. CUDA Rust cierra esa brecha: permite escribir los kernels en Rust y compilarlos de forma nativa a PTX, en lugar de envolver código procedente de otros lenguajes.
Hay dos vías para usar Rust, que se corresponden con las dos vías que ya tiene el propio CUDA. SIMT es el modelo conocido de CUDA C++ o numba-cuda: se describe lo que hace un hilo y se lanzan miles de ellos. Tile es un modelo de programación más reciente, disponible también en C++ y Python, en el que se expresa lo que hace un tile de datos y el compilador Tile IR se encarga del resto. La recomendación de NVIDIA es recurrir primero a Tile, porque el compilador decide cómo se asignan los tiles a cada arquitectura y el código fuente queda libre de decisiones específicas de la arquitectura; se baja a SIMT cuando se necesita ese nivel de control o se quiere gestionar la memoria y los hilos directamente. La elección del lenguaje es independiente de la elección del modelo, y está prevista la interoperabilidad entre lenguajes, de modo que optar por Rust no deja fuera los demás frontends.
La vía SIMT es cuda-oxide, un backend de generación de código personalizado de rustc. Intercepta la compilación, lleva las funciones #[kernel] a través de Rust MIR, el framework Pliron IR y LLVM IR hasta PTX, y entrega todo lo demás al backend estándar. Los dialectos de GPU sobre Pliron son de NVIDIA, y cada transformación permanece en Rust hasta que entra en juego el backend estándar de LLVM. Los requisitos incluyen Linux, una GPU con compute capability 8.0 o superior, el CUDA toolkit 12.x o más reciente, clang con sus encabezados de libclang y la toolchain nightly fijada. El subcomando de Cargo cargo-oxide gestiona la compilación, y cargo oxide doctor verifica la toolchain. El proyecto se genera con cargo oxide new, y la primera cargo oxide run compila el backend de generación de código, de modo que las ejecuciones posteriores reutilizan la caché.
La vía Tile es cutile-rs, que opera un nivel más arriba: se realizan cálculos sobre tiles en lugar de escalares. Cada bloque de tiles ejecuta el cuerpo del kernel una sola vez como un único hilo lógico sobre un subtensor de datos, y el compilador decide cuántos hilos reales de la GPU lo respaldan. La macro #[cutile::module] incrusta el AST del kernel en el binario del host y lo compila con JIT mediante CUDA Tile IR la primera vez que se necesita el kernel. Los requisitos son menos exigentes que los de la vía SIMT: una GPU con compute capability 8.0 o superior, CUDA 13.3, Rust estable 1.89 o posterior y Linux, sin toolchain nightly y sin un LLVM propio. Como cutile está publicado, basta con ejecutar cargo add cutile, sin clonar nada.
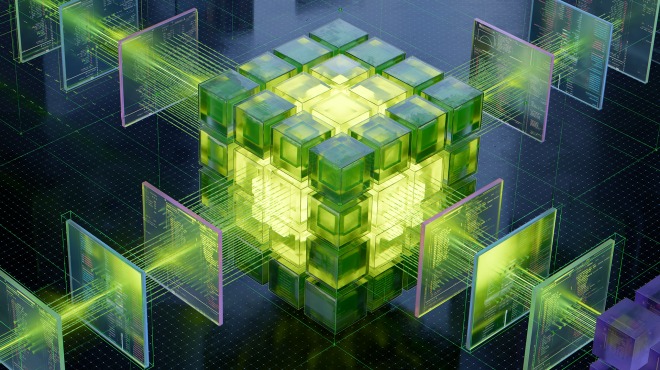
Ambos caminos plantean el mismo argumento de seguridad respecto a la memoria. En el ejemplo de SIMT, el búfer de salida mutable es un DisjointSlice<f32>, un tipo creado a propósito que da a cada hilo acceso exclusivo a su propio elemento, porque &mut [f32] no tiene la forma adecuada cuando cada hilo necesitaría el mismo préstamo mutable. El lanzamiento se comprueba en lugar de darse por bueno: la declaración #[launch_contract] se valida frente a LaunchConfig1D y a los límites reales del dispositivo, y los kernels sin contrato exponen únicamente métodos de lanzamiento unsafe sin procesar. Por el lado de Tile, la partición entrega a cada bloque de tile un subtensor escribible que ningún otro bloque puede solapar, y esa exclusividad es justo lo que ya garantiza &mut. Pasar el búfer de salida de un kernel como una de sus propias entradas no compila, lo que detecta condiciones de carrera por aliasing que de otro modo pasarían las pruebas y luego fallarían en producción.