Оптимизация AI-инференса через совместное проектирование памяти на всех уровнях стека
 Public
- 06 Nov, 2026
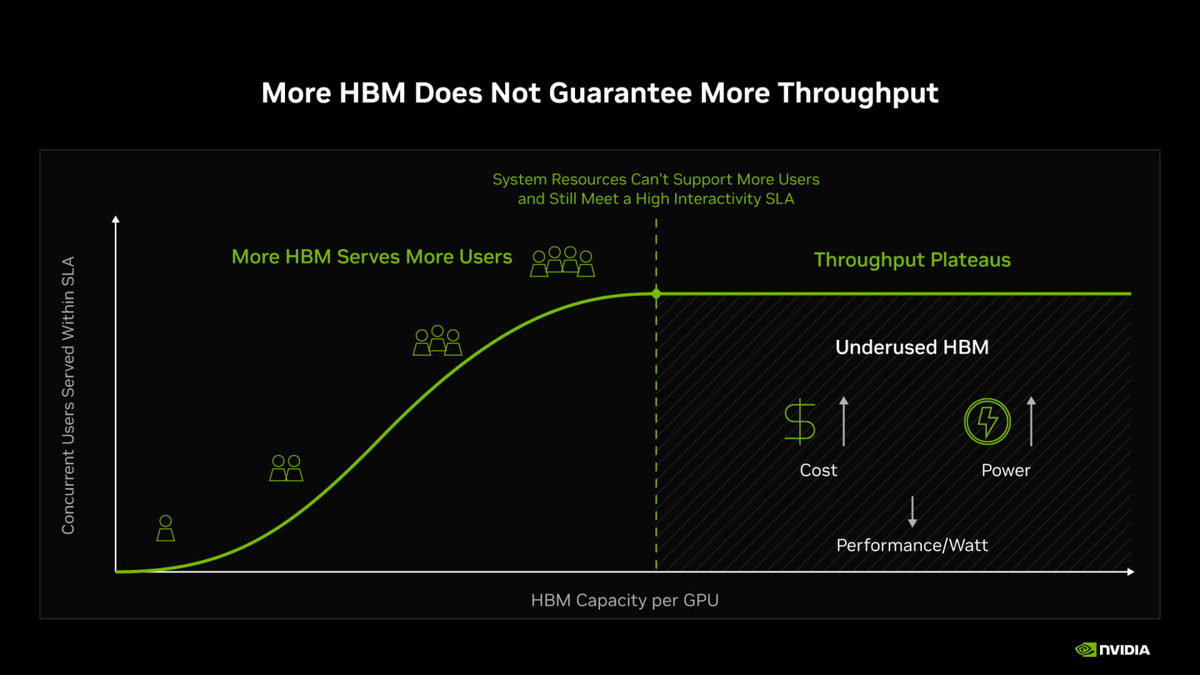
Стремительное расширение больших языковых моделей, увеличение контекстных окон и рост агентных приложений создают всё более сильное давление на ресурсы памяти GPU. На фоне ужесточения условий поставок и роста цен отрасль сталкивается с критической задачей: как обрабатывать больше данных, не прибегая к простому наращиванию дорогостоящего оборудования. NVIDIA решает эту проблему, отказываясь от традиционного подхода, основанного на установке большего объёма памяти High Bandwidth Memory (HBM) на чипы. Вместо этого компания применяет стратегию полного совместного проектирования (full-stack codesign), где GPU, CPU, сетевое оборудование, системы хранения и программное обеспечение разрабатываются синхронно. Эта целостная цель - извлечь максимум полезной работы из каждого байта памяти во всей инфраструктуре AI-фабрики, а не полагаться исключительно на увеличение сырой ёмкости.
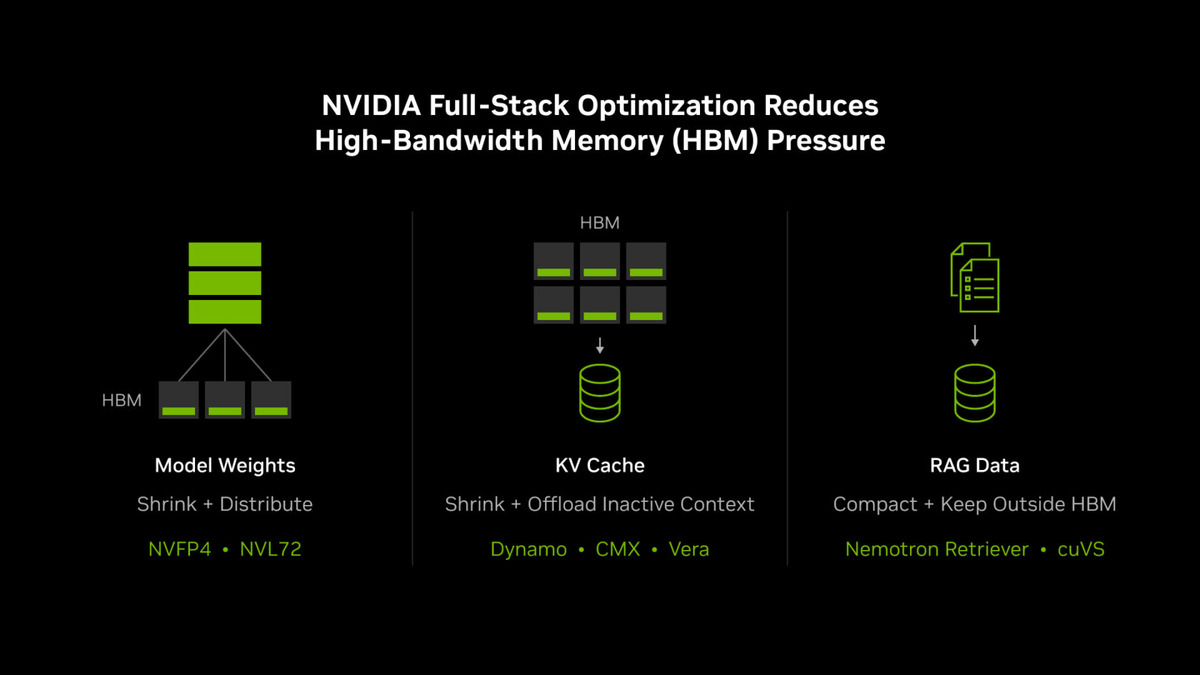
Суть этой стратегии заключается в эффективном управлении иерархией памяти и хранения. В AI-фабрике HBM выступает самым быстрым, но самым дорогим и востребованным уровнем, хранящим критически важные данные, такие как веса моделей и кэш Key-Value (KV). Ниже этого уровня находятся память CPU, локальные SSD и общее хранилище, которые предлагают больший объём за меньшие деньги, но с меньшей скоростью. Эффективность системы зависит от того, насколько грамотно данные размещаются и перемещаются между этими уровнями. Сокращая размер весов моделей, выгружая неактивные контексты KV-кэша в более дешёвое хранилище и уплотняя эмбеддинги для генерации с дополнением из поиска (RAG), NVIDIA обеспечивает то, чтобы ограниченное пространство HBM оставалось доступным для активных операций высокого приоритета. Это предотвращает эффект «стены памяти», когда вычислительные блоки простаивают в ожидании данных из-за насыщения пропускной способности, поддерживая низкую задержку для одновременных пользователей.
Влияние такого подхода к совместному проектированию наглядно видно в последних метриках производительности платформ. От поколения Blackwell Ultra до будущей платформы Vera Rubin ёмкость HBM на один GPU выросла всего на 3%. Однако прирост эффективности оказался значительным. В бенчмарке SemiAnalysis AgentX пропускная способность агентных задач на доллар выросла до 30 раз. Конкретно, NVIDIA GB300 NVL72 обеспечивает пропускную способность на доллар до 10 раз выше, чем платформа H200, при скорости 100 токенов в секунду на пользователя, несмотря на удвоение ёмкости HBM. Ожидается, что Vera Rubin NVL72 обеспечит пропускную способность на доллар до 30 раз выше, чем GB300 NVL72, при скорости 125 токенов в секунду на пользователя, при этом ёмкость HBM увеличится всего на 3%. Это демонстрирует, что оптимизация потока данных и размещения в хранилище приносит гораздо большую отдачу, чем простое расширение ёмкости памяти.
Для операторов AI-фабрик ключевой метрикой является количество полезных токенов, доставленных в рамках конкретного энергетического бюджета при соблюдении строгих требований к времени отклика. Увеличение количества токенов в секунду на ватт напрямую ведёт к росту выручки от той же энергетической инфраструктуры и снижению стоимости за токен. Снимая нагрузку с HBM за счёт весов моделей, простоящего контекста и данных RAG, полное совместное проектирование гарантирует, что ресурсы памяти используются для активного инференса, а не пассивного хранения. Этот метод позволяет системам обрабатывать триллионы параметров и сложные агентные траектории, которые могут включать обработку до 3 миллионов токенов, без узких мест, вызванных пропускной способностью памяти. Результатом становится более масштабируемая и экономически эффективная инфраструктура, способная поддерживать следующее поколение AI-приложений.