Оптимизация CUDA-конвейера обработки изображений: от багов до бенчмарков
 Public
- 02 Sep, 2026
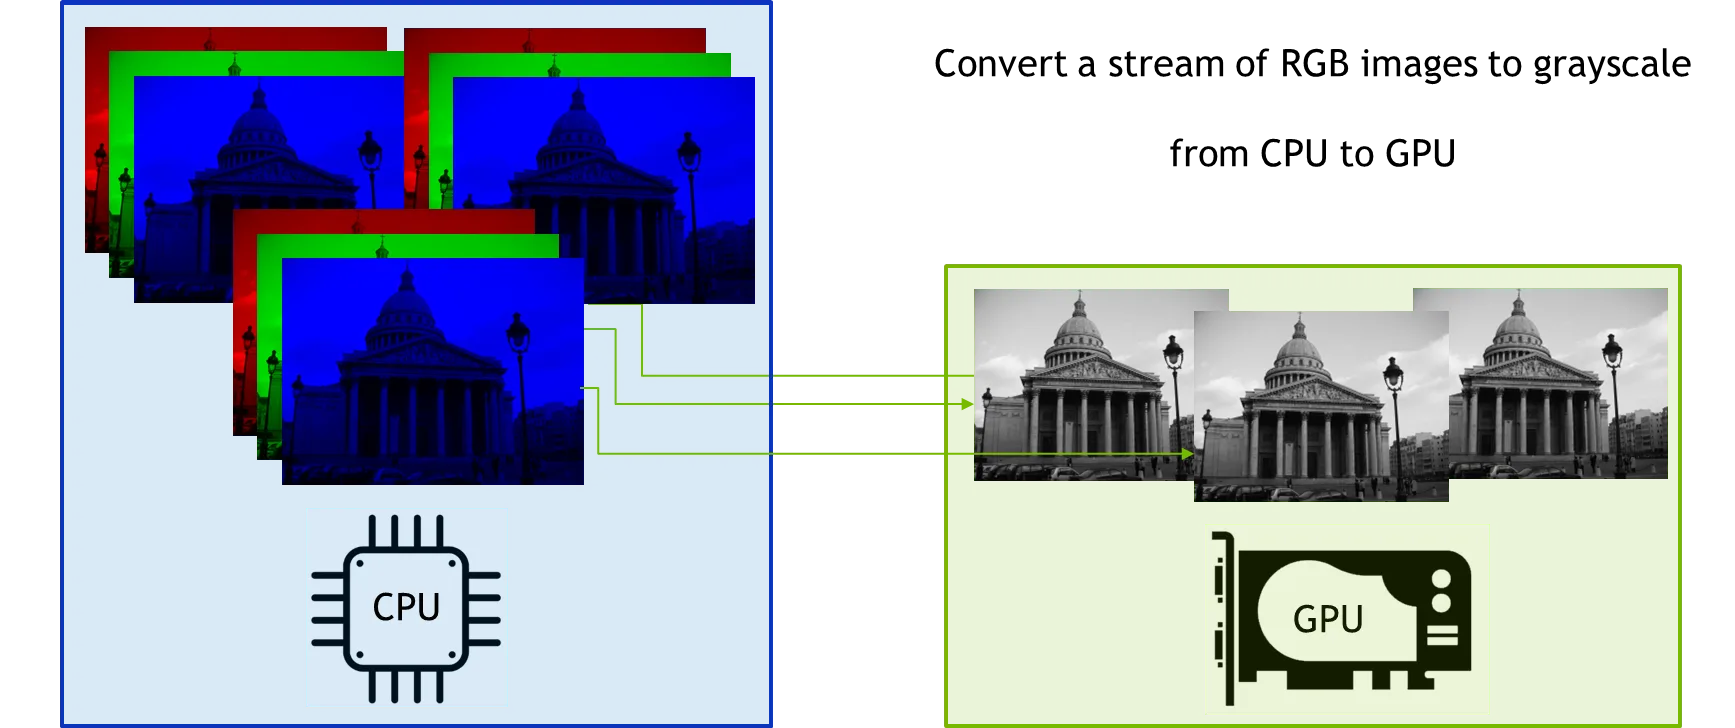
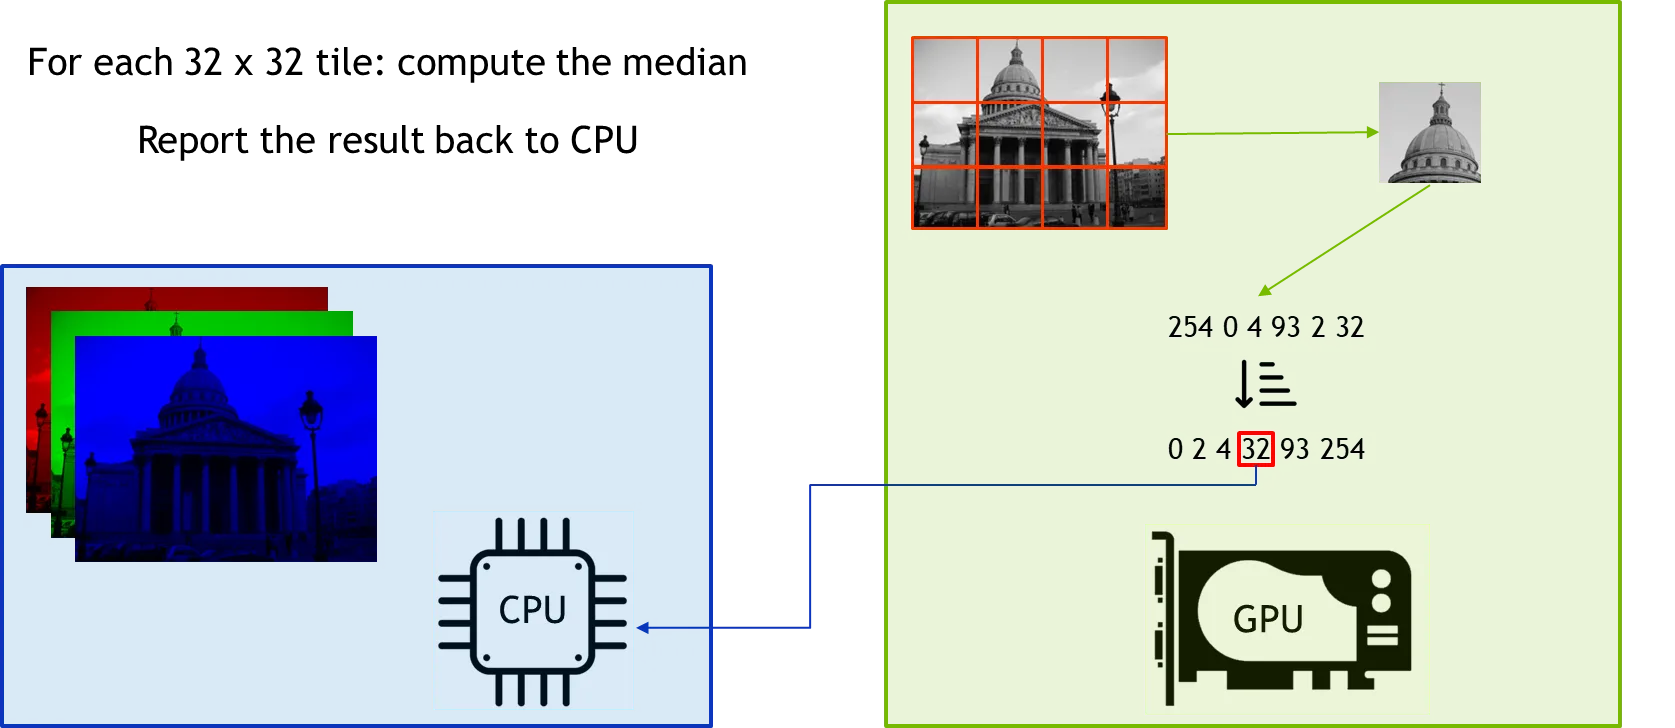
В этом практическом примере CUDA обрабатывается поток красных, зелёных и синих изображений: данные сначала копируются с CPU на GPU, переводятся из RGB в оттенки серого, затем каждая плитка размером 32 на 32 пикселя сортируется, чтобы можно было вычислить её медиану, и в конце медианы копируются обратно на хост. В исходной реализации определены два ядра — computeRGBToGray для преобразования цвета и computeMedian<TILE_WIDTH, HISTO_SIZE> для медианы по каждой плитке, — а main выделяет память, запускает ядра и освобождает ресурсы внутри параллельного цикла OpenMP по трём изображениям.
В ядре медианы скрыт тонкий, но серьёзный дефект. Запись в разделяемую память tile[index] = d_image_gray[index] по ошибке использует глобальный индекс для записи в разделяемую память, которая ограничена одним блоком потоков. Запуск бинарника выдаёт ошибку «illegal memory access», и compute-sanitizer точно указывает причину: запись за пределы __shared__ на один байт в строке 55, зафиксированная для потока (0,3,0) в блоке (20,0,0).
Чтобы не допускать подобных ошибок с индексацией, NVIDIA представила в CCCL новый API запуска. Ядра запускаются через cuda::make_config, cuda::block_dims, cuda::grid_dims и cuda::launch, затем ядро принимает конфигурацию первым параметром и использует cuda::gpu_thread.index(cuda::grid, config) и cuda::gpu_thread.index(cuda::block, config), чтобы получать глобальный и блочный индексы по отдельности. Сырые указатели также можно заменить на cuda::std::span, cuda::std::mdspan и cuda::shared_memory_mdspan, которые в отладочном режиме срабатывают ассертами при доступе за пределы массива.
Когда код становится безошибочным, его замеряют с помощью Nsight Systems. Разметка кода диапазонами NVTX — такими как nvtx3::scoped_range и nvtxRangePushA/nvtxRangePop — делает таймлайн удобнее для чтения и показывает, что ядро вычисления медианы доминирует в профиле: оно занимает около 2,1 секунды на изображение и отвечает за 98,5% времени GPU, тогда как операции с памятью — лишь за 1,5%.
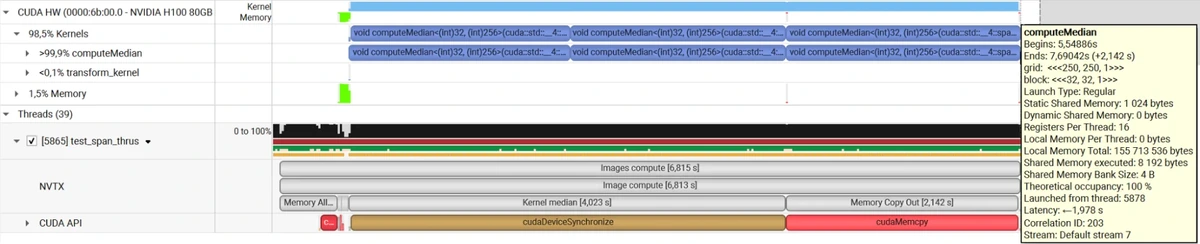
Со стороны CPU весь этап вычислений над изображением занимает 6,8 секунды, и почти всё это время уходит на ядра медианы. Такой таймлайн даёт разработчику ясную цель для следующих шагов оптимизации: вычисление медианы — самая дорогая часть конвейера, и последующие этапы разбора сосредоточены именно на её улучшении.