NVIDIA TensorRT 11.1: глобальный тюнер производительности для автоматической оптимизации движков с учётом точности
 Public
- 24 Oct, 2026
Развёртывание нейросетей - это по сути задача компиляции, где не существует единой оптимальной стратегии для всех моделей. Когда NVIDIA TensorRT собирает движок инференса, он принимает взаимосвязанные решения о трансформациях графа, слиянии ядер, размещении памяти и квантовании. Этот процесс, известный как планирование (scheduling), сильно влияет на итоговую производительность инференса. Разные варианты планирования могут сохранять семантику модели, но давать совершенно разные результаты по скорости. Поскольку эти эффекты связаны между собой и зависят от конкретной модели, они часто проявляются только после полной сборки и замера движка. Это делает предсказание лучшей стратегии всё более сложным по мере разнообразия моделей и сред развёртывания.
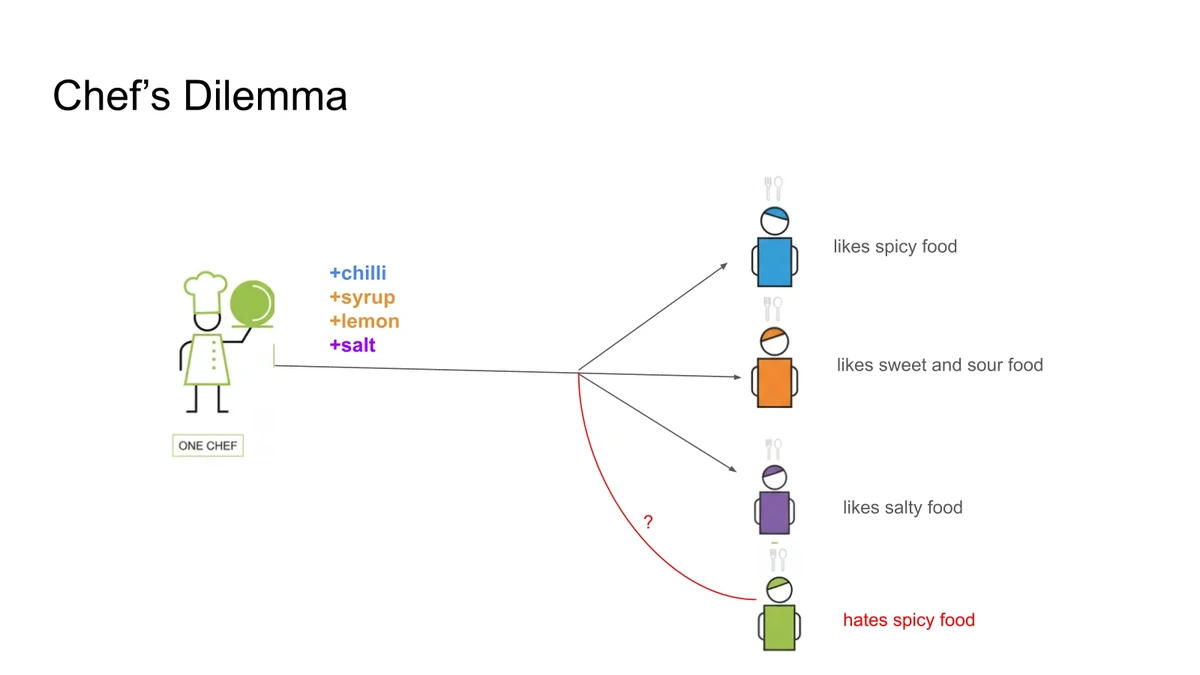
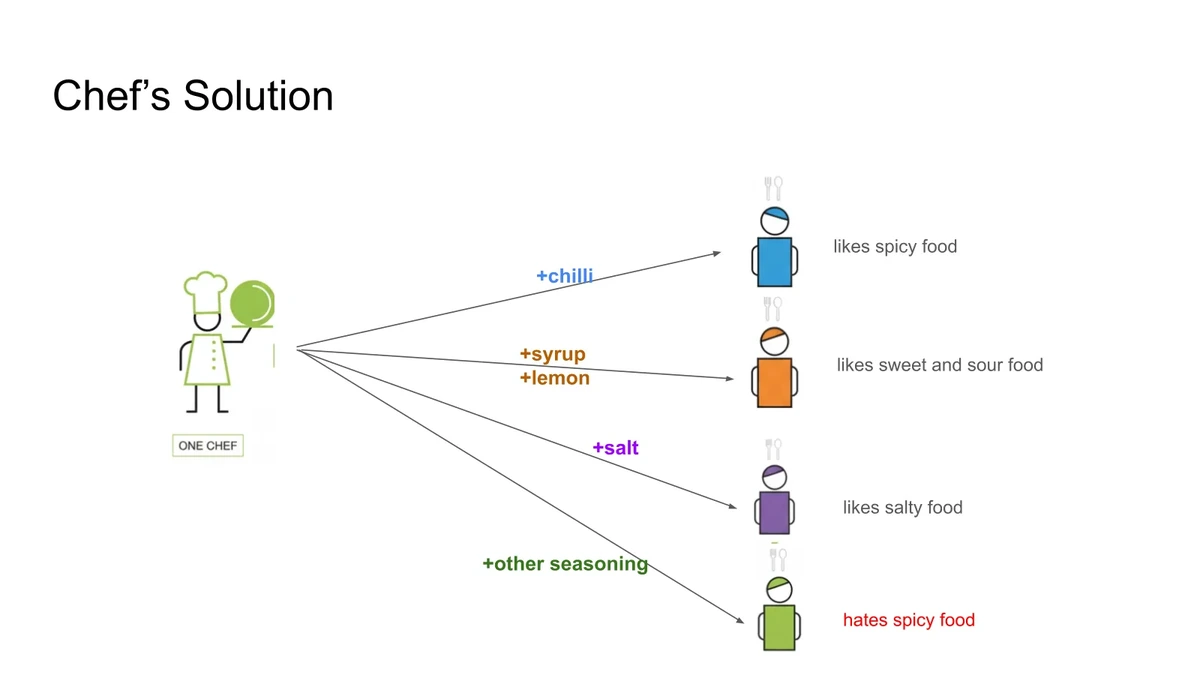
Исторически TensorRT полагался на внутренние модели ключевых показателей эффективности (KPI) для выявления оптимизируемых паттернов, которые затем кодировались в виде эвристик в стандартной стратегии планирования. Хотя это позволяло пользователям автоматически пользоваться экспертными знаниями, возникла проблема масштабируемости. Эвристика, разработанная для одного типа моделей, могла вызывать деградацию производительности на другом, требуя дополнительных исключений. Это делало логику планирования сложной и трудно расширяемой. Global Performance Tuner, представленный в TensorRT 11.1, решает эту проблему, отказываясь от единственного фиксированного рецепта. Вместо этого он рассматривает конвейер компилятора как базовый рецепт с настраиваемыми «специями», позволяя системе адаптировать путь оптимизации под конкретные характеристики входной модели, будь то граф ONNX или сеть, созданная через API TensorRT.
Чтобы формализовать этот подход, система использует математическую рамку, разделяющую генерацию кандидатов и их выбор. Пространство моделей состоит из всех возможных входных данных, а пространство решений - из всех исполняемых выходов, таких как движки TensorRT или сериализованные последовательности GPU-ядер. Алгоритм сборки (builder) отображает модель в набор кандидатов, ограниченный порогом допустимой погрешности. Этот порог гарантирует, что пары «вход-выход» остаются в допустимых пределах, предотвращая агрессивные оптимизации, которые нарушают требования приложения. Цель алгоритма сборки - сгенерировать богатый набор кандидатов, включающий оптимальное решение, определяемое как самое быстрое допустимое выполнение, удовлетворяющее критериям точности. Эта абстракция позволяет строго анализировать, как разные маршруты сборки влияют на итоговое время выполнения.
Затем алгоритм поиска работает с этим набором кандидатов, чтобы выбрать лучшее решение. В идеале этот алгоритм должен был бы выполнить перебор всех кандидатов, чтобы найти тот с минимальным временем выполнения. Однако на практике бюджеты времени сборки часто ограничивают глубину такого поиска. Таким образом, весь компилятор представляется как кортеж из сборщика (builder) и поисковика (searcher). Сложность заключается в построении оптимального сборщика, который делает глобально оптимальное решение достижимым. Поскольку единого универсального маршрута сборки не существует для всех моделей, система должна поддерживать настраиваемые маршруты. Это означает, что последовательность проходов компилятора, преобразующих промежуточные представления в финальные исполняемые файлы, может варьироваться. Разные модели могут достигать лучшей производительности через разные последовательности трансформаций, даже на одном и том же целевом GPU.
Global Performance Tuner использует эти настраиваемые маршруты сборки для автоматической настройки производительности. Для каждого кандидата, сгенерированного разными маршрутами, тюнер проверяет выходные данные на соответствие заданному критерию точности. Затем он измеряет сквозную производительность инференса для допустимых решений. Среди всех кандидатов, удовлетворяющих требованиям к точности, система выбирает тот с наименьшим временем выполнения. Такой подход гарантирует, что прирост производительности не достигается за счёт потери точности модели. Рассматривая процесс компиляции как поиск по множеству возможных маршрутов сборки, а не как единственный фиксированный путь, TensorRT 11.1 предлагает масштабируемый метод оптимизации задач глубокого обучения для разнообразных моделей и аппаратных конфигураций.
Эта методология устраняет ключевое ограничение предыдущих подходов, где изменение для одной модели могло ухудшить производительность для другой. Держа базовый конвейер стабильным, но делая решения о планировании настраиваемыми, система эффективно справляется с новыми моделями с неизвестными предпочтениями. Она предлагает различные варианты оптимизации, отклоняет те, которые не проходят проверку точности, и сохраняет конфигурацию с наилучшей производительностью. Это аналогично шефу, который предлагает новому клиенту бесплатные образцы, чтобы найти предпочтительную комбинацию специй, а не навязывает один стандартный рецепт. Результатом становится более устойчивый процесс компиляции, который адаптируется к конкретным потребностям каждой нейросети, обеспечивая разработчикам максимально возможную скорость инференса без ущерба для требуемой точности их приложений.