NVIDIA Snapshot сокращает запуск GPU-нагрузок до секунд
 Public
- 11 Nov, 2026
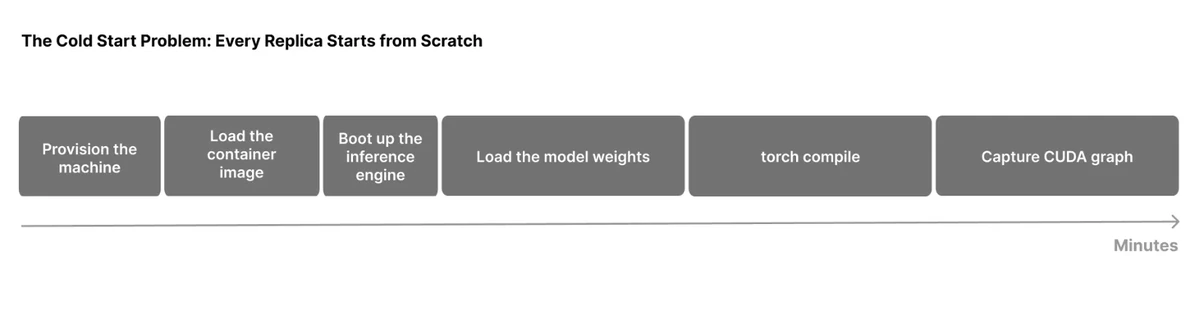
NVIDIA представила Snapshot - открытый компонент платформы NVIDIA DSX AI Factory Platform, который позволяет повторно использовать инициализированные GPU-нагрузки в разных репликах инференса. Проблема знакома всем, кто обслуживает LLM: когда спрос резко растёт или реплика выходит из строя, свободные GPU не становятся мощностью для обслуживания сразу, потому что инициализация нагрузки LLM - холодный старт - может занимать минуты. Snapshot - это система контрольных точек и восстановления для GPU-нагрузок в Kubernetes. Она сохраняет полностью инициализированную нагрузку, включая память CPU и GPU, и восстанавливает это состояние на совместимой инфраструктуре, выводя мощность инференса в сеть за секунды, а не за минуты. Подготовка инфраструктуры и загрузка образа контейнера в измеряемый путь восстановления не входят.
Инструмент предоставляет две операции для GPU-подов, обе управляются через пользовательские ресурсы Kubernetes. Чтобы сохранить контрольную точку работающего пода, вы создаёте PodSnapshot с его именем; чтобы запустить под из шаблона и сразу сохранить его контрольную точку, когда он будет готов, вы создаёте SnapshotJob. Восстановление означает добавление аннотации nvidia.com/restore-from к новому поду и указание PodSnapshot, из которого нужно восстановиться. Сама нагрузка требует лишь небольшого рукопожатия, чтобы приостановиться перед созданием контрольной точки и продолжить работу после восстановления, а в репозитории есть готовые примеры для vLLM, SGLang и NVIDIA TensorRT LLM. Snapshot умеет сохранять и восстанавливать совместимые нагрузки, охватывающие несколько GPU на одном узле, как единый артефакт по всем рангам - это обеспечивает быстрый запуск больших моделей mixture-of-experts с тензорным параллелизмом, параллелизмом данных и экспертов, а также параллелизмом контекста декодирования, при условии что нагрузка соответствует требованиям совместимости контрольных точек, восстановления и среды выполнения.
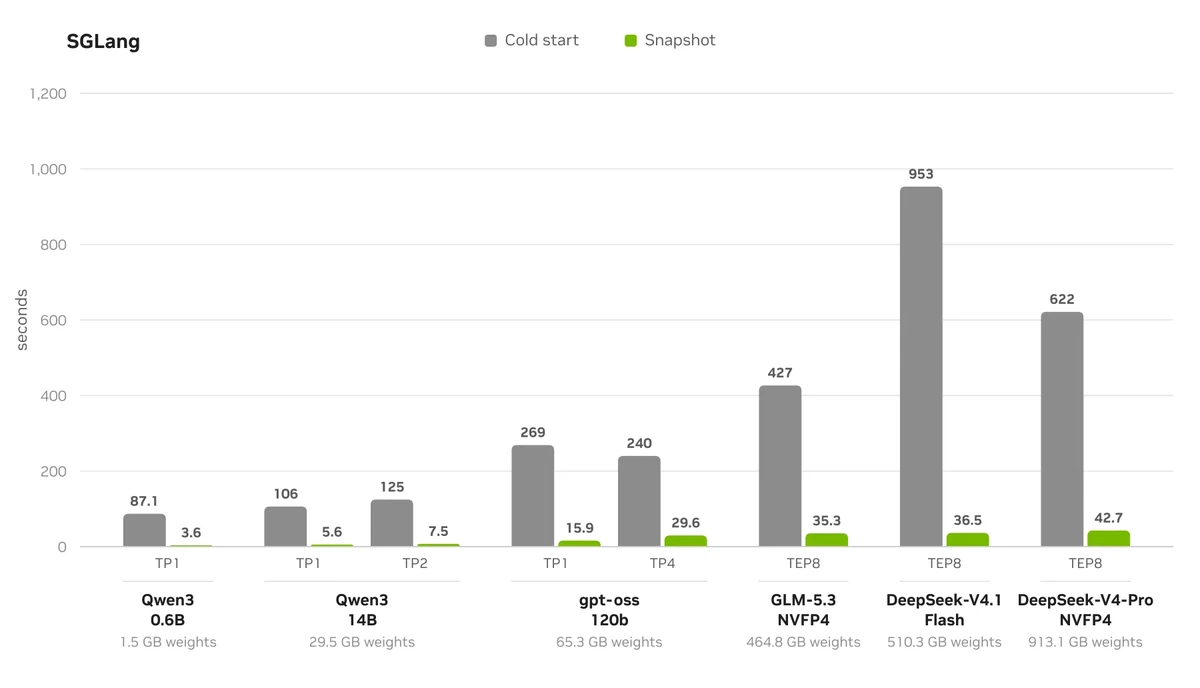
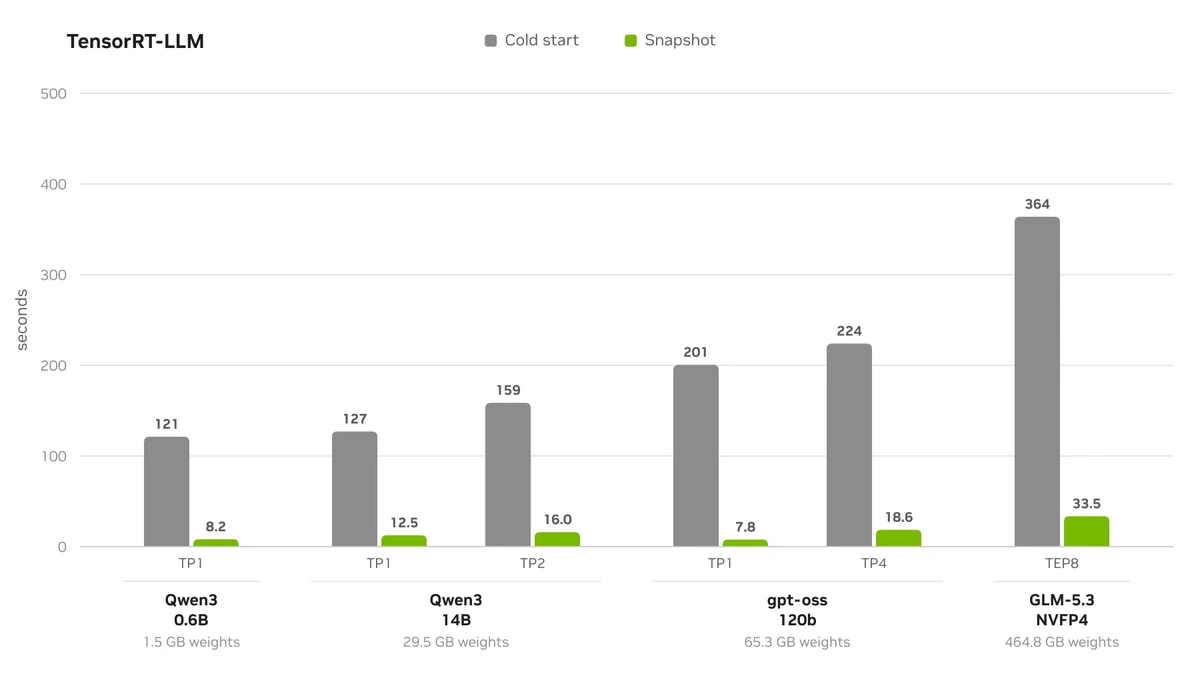
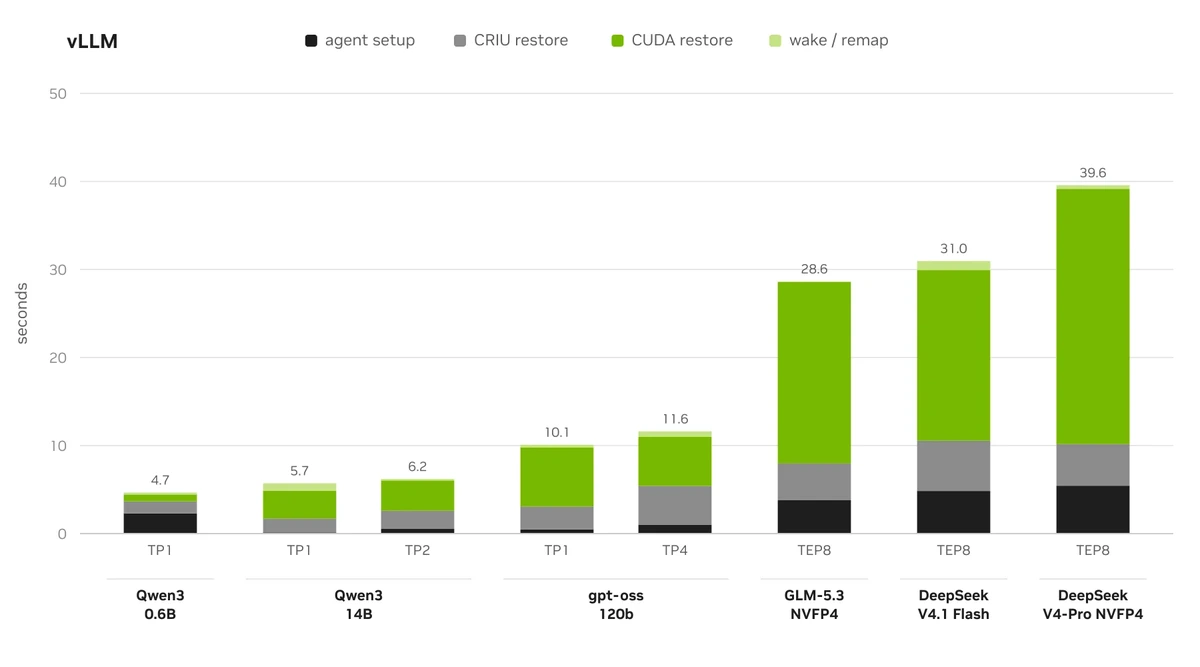
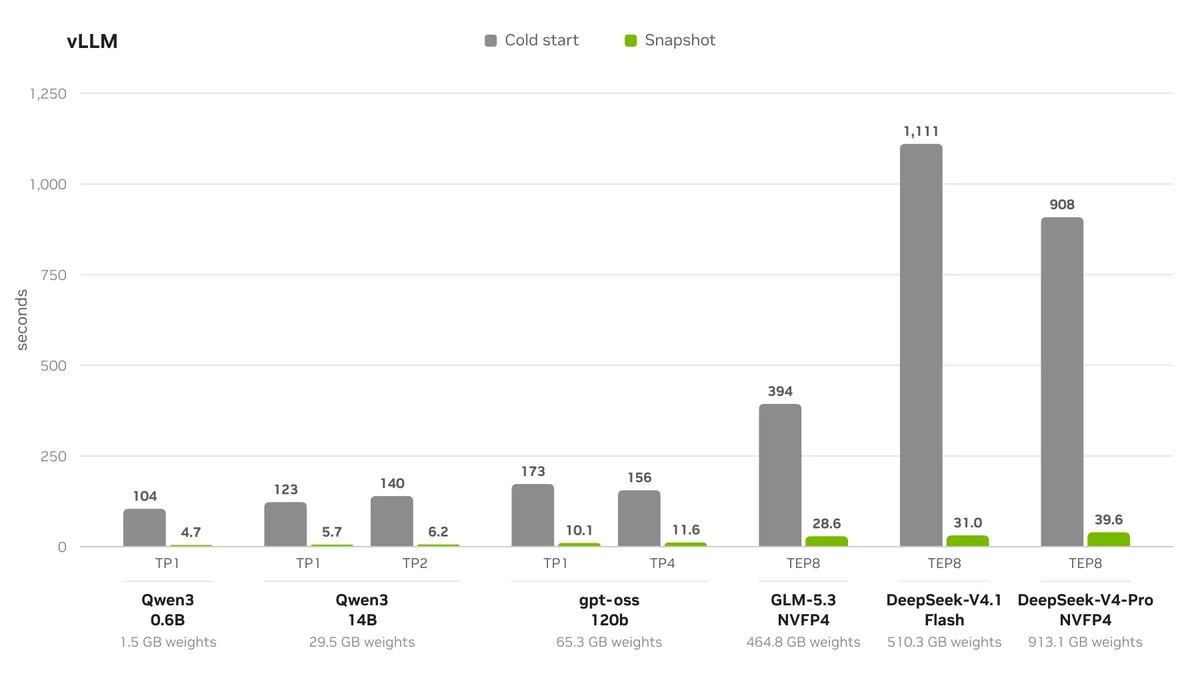
Бенчмарки охватывают модели от 600 миллионов параметров до MoE-моделей с контрольными точками на 1 ТБ на 8 GPU; тесты проводились на одинаковом оборудовании и программном стеке по двум стратегиям: холодный старт против восстановления из Snapshot. Во всех протестированных конфигурациях Snapshot возвращает реплику в строй менее чем за 45 секунд - в 8-36 раз быстрее холодного старта. По движкам диапазоны восстановления такие: vLLM - от 4,7 до 39,6 секунды, SGLang - от 3,6 до 42,7 секунды, TensorRT LLM - от 7,79 до 33,55 секунды. Оба замера не учитывают загрузку образа контейнера и настройку среды выполнения контейнера, а освобождение KV-кэша запускается перед каждой контрольной точкой, поэтому в артефакт оно не входит. Время создания контрольной точки и размер артефакта указаны как разовая стоимость на модель и конфигурацию.
Сам путь восстановления состоит из настройки агента, восстановления CRIU, восстановления CUDA и пробуждения с перепривязкой, а разбивка холодного старта показывает, какие фазы инициализации восстановление пропускает. Изначально Snapshot разрабатывался для воркеров инференса NVIDIA Dynamo, но задуман для интеграции другими движками инференса, планировщиками, контроллерами и платформами. Инструменты бенчмаркинга и инструкции по воспроизведению лежат в репозитории вместе с руководством по установке и использованию, а руководство пользователя Dynamo описывает восстановление воркеров. Партнёры по разработке также оценили Snapshot на своих нагрузках.