NVIDIA внедряет ИИ-агентов для автоматизации работы ИИ-фабрик и снижения нагрузки на SRE
 Public
- 05 Nov, 2026
По мере роста масштабов GPU-кластеров инженеры по надежности сайтов (SRE) сталкиваются с трудностями при сопоставлении падений производительности на уровнях вычислений, сети и оборудования. NVIDIA разработала AI Factory Operations Agent, чтобы оптимизировать внутреннюю эксплуатацию DGX SuperPOD и сократить ручной труд. Система использует специализированных агентов, которые обнаруживают сбои, определяют их первопричины и дают рекомендации через чат-интерфейс. Инженеры могут общаться с этими агентами на естественном языке, переключаться между расследованиями и отслеживать действия для аудита, что избавляет от необходимости вручную проверять множество дашбордов.
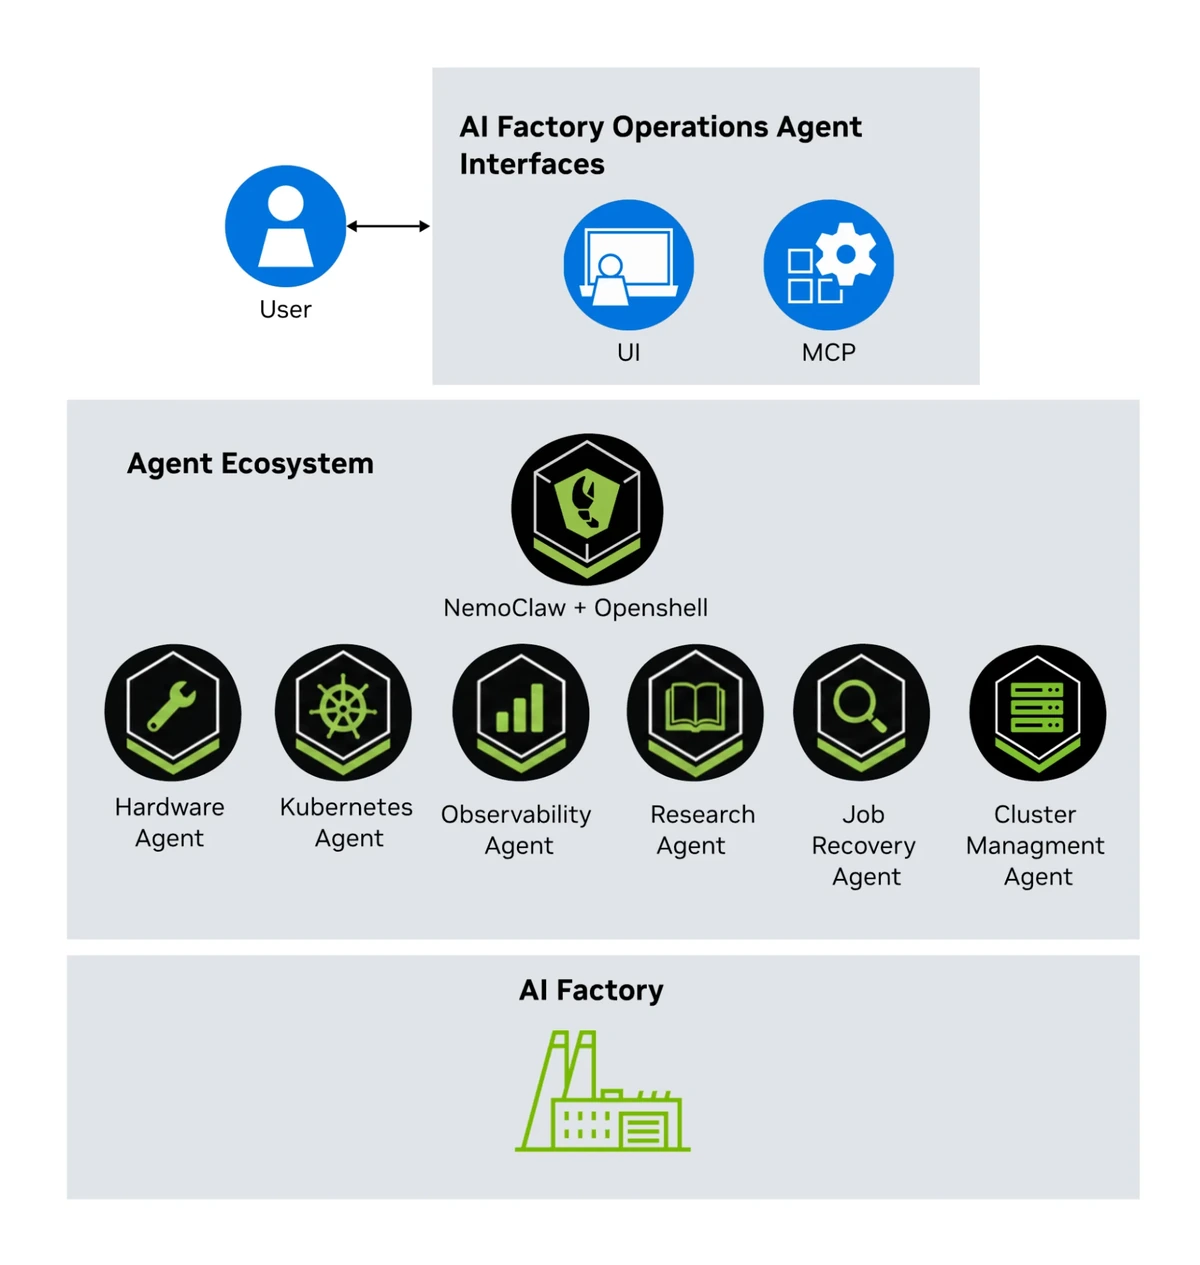
Пример для разработчиков построен на основе шаблона NVIDIA NemoClaw и включает пользовательский агентский рантайм, который направляет запросы к доменным агентам. Связь устанавливается через плагины OpenClaw и серверы Model Context Protocol, которые предоставляют доступ к узкоспециализированным операционным инструментам. Фреймворк использует NVIDIA OpenShell и поддерживает полностью локальное развертывание для обеспечения суверенитета данных. Инференс опирается на локально обслуживаемые открытые модели NVIDIA Nemotron, работающие в производственных кластерах DGX H100, B200 и GB300. Такая модульная архитектура позволяет добавлять новых агентов и интеграции с инфраструктурой без изменения существующих компонентов.
Развертывание выполняется как приложение Kubernetes control-plane, где Helm управляет UI, шлюзом OpenClaw, серверами MCP и точками входа для инференса. Для выполнения команд в оболочке OpenShell создает изолированные песочницы Kubernetes для каждой сессии, отделяя команды от основного пода шлюза и гарантируя, что рантайм не изменяет производственные нагрузки. Безопасность обеспечивается многоуровневым контролем доступа. Серверный инструмент run_kubectl использует зафиксированные бинарные файлы и учетные данные только для чтения, а RBAC Kubernetes определяет доступные для просмотра ресурсы. Такая конфигурация позволяет агентам проверять свои права, например, подтверждая возможность получения списка подов, но не секретов или создания новых подов.
Внутреннее развертывание использует набор доменных агентов. Job Recovery Agent анализирует сбои обучения на уровнях планировщика и оборудования. Hardware Agent диагностирует неисправности на уровне устройств, такие как ошибки PCIe и тепловые аномалии. Observability Agent запрашивает данные из Prometheus и Grafana Loki для генерации динамических дашбордов. Research Agent ищет информацию в предварительно загруженной документации, а Kubernetes Agent предоставляет доступ к состоянию кластера только для чтения. Cluster Management Agent взаимодействует с API Base Command Manager. Кросс-доменные инструменты включают веб-поиск и выполнение кода, а фреймворк поддерживает кастомные серверы MCP для специфических операционных задач.
NVIDIA рекомендует выделенный GPU-ускоренный control-plane, изолированный от производственного кластера, для обработки оркестрации агентов без потребления ресурсов, необходимых для обучения. В многопользовательских средах OpenShell обеспечивает границы, запуская агентов в изолированных песочницах с ограничениями на уровне ядра, что гарантирует доступ SRE арендаторов только к их конкретным пространствам имен и узлам. Фреймворк доступен как экспериментальное программное обеспечение с открытым исходным кодом на GitHub, хотя API и конфигурации могут меняться между релизами. Клиенты NVIDIA могут связаться с менеджерами по работе с клиентами, чтобы запросить доступ к проприетарным агентам управления кластером, разработанным для внутреннего использования.