Daviator ускоряет VASP на GPU NVIDIA: пакетный расчёт k-точек и смешанная точность
 Public
- 18 Nov, 2026
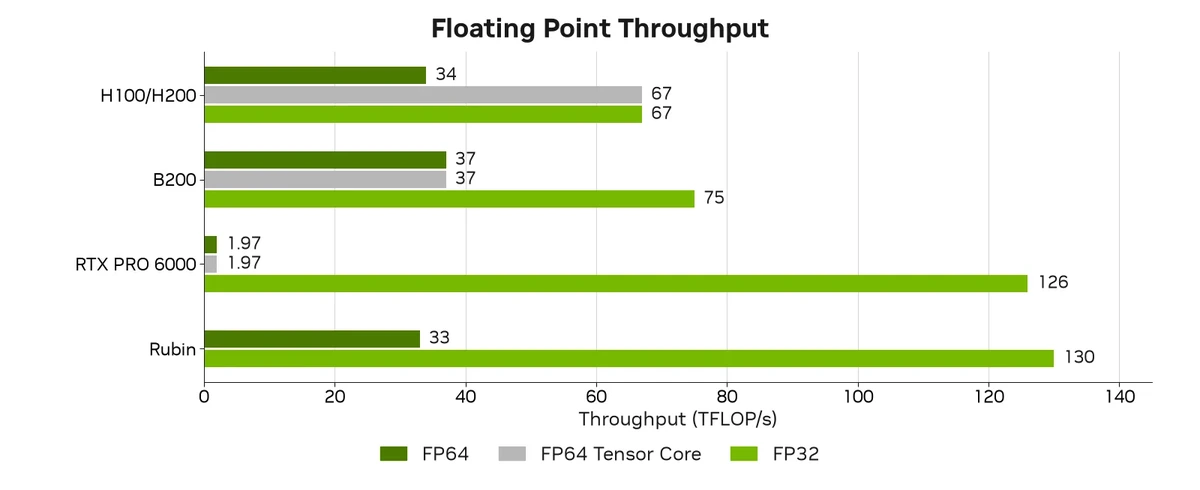
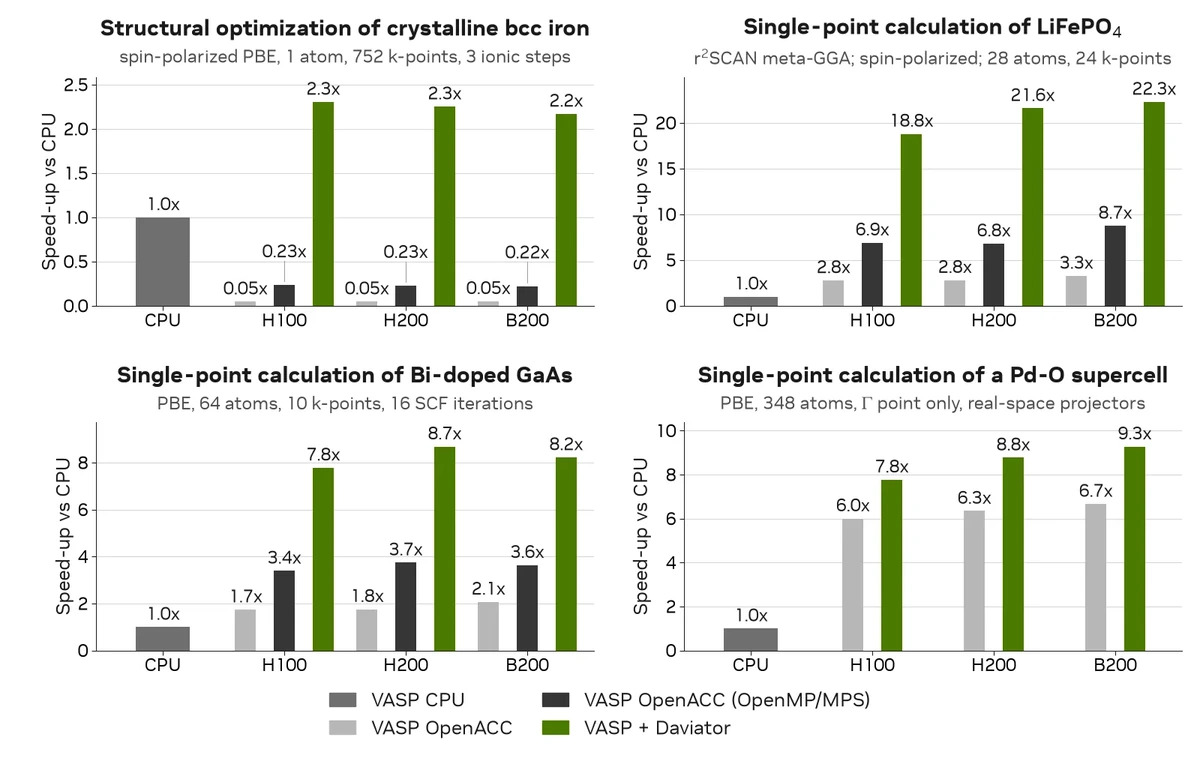
Чтобы обучить машинно-обученные межатомные потенциалы (MLIP), нужны десятки и сотни миллионов DFT-расчётов энергий, сил и напряжений. Чаще всего их получают в VASP - основном коде DFT на плоских волнах. В таких задачах обычно берут небольшие элементарные ячейки и плотные сетки k-точек, и GPU при этом простаивают. Порт VASP на OpenACC обрабатывает k-точки по очереди, поэтому для малых систем на каждом шаге запускаются сотни крошечных ядер, и накладные расходы на запуск съедают всё время. Система из одного атома железа с 752 k-точками считалась на GPU в 8 раз медленнее, чем на CPU, и исследователям приходилось вручную распределять задачи по размеру. К тому же FP64 топчется на месте: производительность в FP64 у Hopper, Blackwell и Rubin не растёт, а FP32 продолжает прибавлять. У RTX PRO 6000 соотношение FP32:FP64 и вовсе 64:1.
Daviator - библиотека GPU-ядер от NVIDIA, которая заменяет циклы по k-точкам пакетными операциями. В её основе лежит пакетный решатель Дэвидсона на пакетных FFT, GEMM и собственных ядрах. Запусков становится меньше, загрузка SM приближается к насыщению, а данные не покидают память GPU. За VASP остаются цикл SCF, смешивание, симметрия и ввод-вывод, а Daviator подключается в чётко заданных точках вызова. Включается он через микросервис NVIDIA ALCHEMI VASP параметром LDAVIATOR=True в INCAR и перехватывает решатель Дэвидсона (ALGO = Normal). Менять существующие входные файлы не нужно. В примере взят один атом Fe с ISPIN = 2, NBANDS = 12, PREC = Accurate и сеткой 30x30x30 с центром в Гамма-точке.
Часть ядер специализирована под размер пакета и может компилироваться при первом использовании. Поэтому в скриптах задач стоит направить CUDA_CACHE_PATH на быстрое хранилище, например /tmp/cudacache, а не в $HOME, и выставить CUDA_CACHE_DISABLE=0. Запускаются расчёты как обычно, например mpirun -np 1 vasp_std. Пока поддерживается только один узел; многоузловой режим, vasp_ncl и vasp_gam в планах. Для сравнения взяли VASP 6.6.0 на CPU и с OpenACC на H100/H200 и B200. Один атом железа считается более чем в 2 раза быстрее, чем на CPU. LiFePO4 с r2SCAN ускоряет решатель Дэвидсона в 22 раза, а GaAs с примесью Bi из 64 атомов тратит на расчёт на 85% с лишним меньше времени. Даже система из 348 атомов с одной k-точкой считается быстрее, так что сортировать задачи по размеру больше не нужно. По оценкам для наборов данных время до результата сокращается до 22 раз, а стоимость - до 75% по сравнению с CPU.
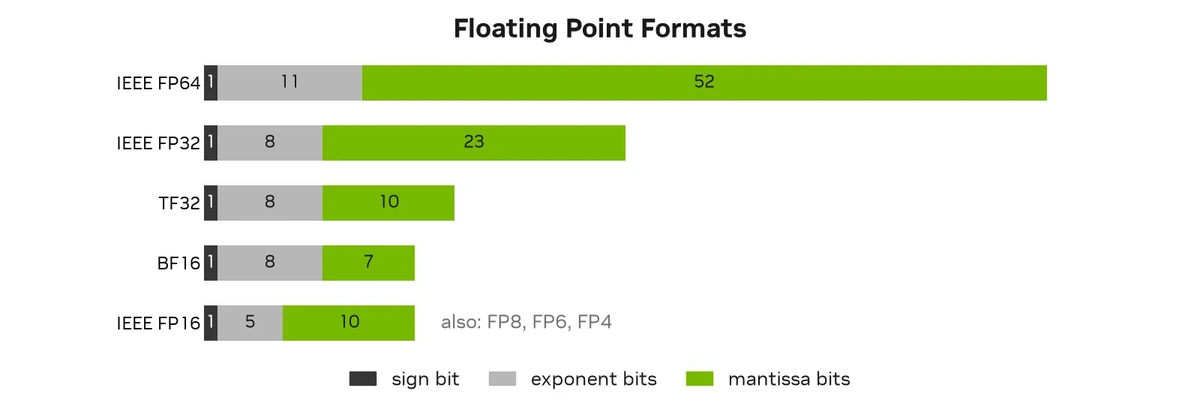
Пакетный Daviator по-прежнему считает в FP64, а сделать решатель Дэвидсона со смешанной точностью непросто. Если перевести ядра на FP32 и сравнить результат с FP64, узнаешь только «прошло» или «не прошло». При этом скрытые сбои - дрейф энергии, сходимость не туда, расходящиеся траектории МД - могут выглядеть вполне правдоподобно. Поэтому используется обобщённый тип с плавающей точкой, у которого настраивается число бит мантиссы и порядка. С его помощью для каждого ядра находят минимально необходимую точность и решают: перевести его на FP32, переписать или оставить «островом» FP64. Результаты зависят от входных данных и порога. Инструментировать нужно в том числе зависимости и математические функции, а медленные инструментированные прогоны можно распараллелить на ресурсах HPC. Начинают с преобразований FP64↔FP32 вокруг горячего пути и ядер с настраиваемым типом, а затем от итерации к итерации сужают области FP64.
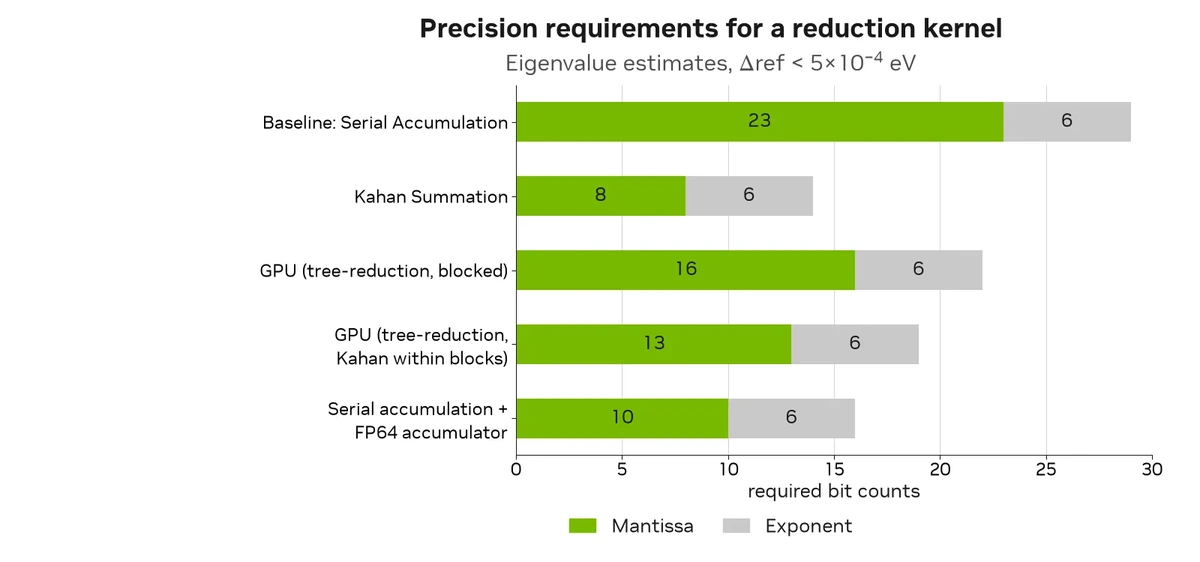
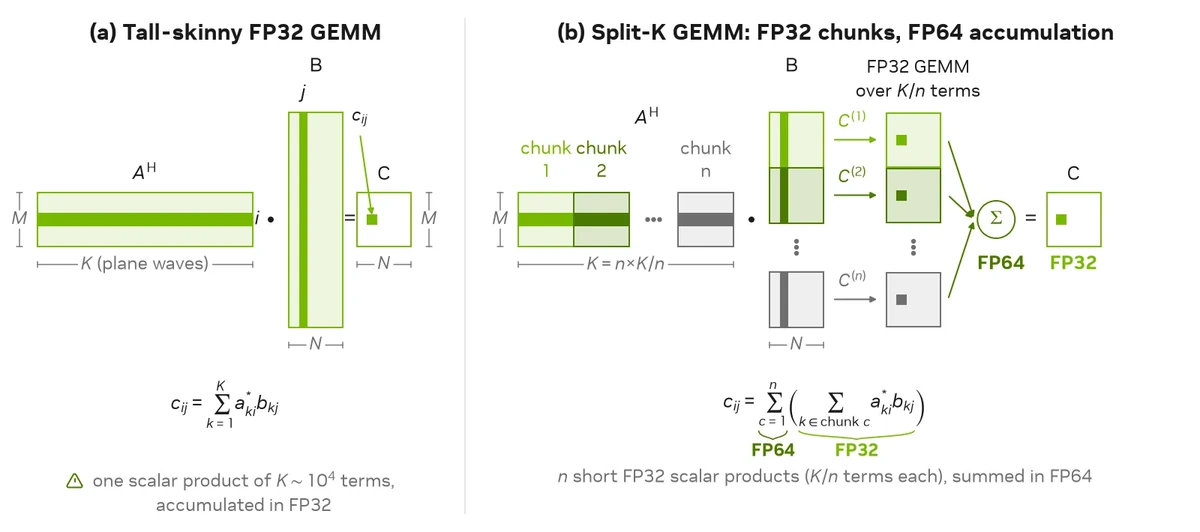
Анализ на основе Verificarlo показал, что FFT, применение гамильтониана и обновление орбиталей можно перевести в FP32. Задача на собственные значения в подпространстве, энергии, критерии сходимости и узкие высокие GEMM, из которых строятся матрицы подпространства, остались в FP64. Эти GEMM метода Рэлея - Ритца питают чувствительный решатель собственных значений, поэтому применяется алгоритм split-k: скалярные произведения считаются блоками в FP32, а итоговое суммирование идёт в FP64. Порог EDIFF в VASP по умолчанию равен 10-4 эВ и может опускаться до 10-6 эВ и ниже, тогда как FP32 даёт около 7 значащих цифр. Смешанный решатель сходится до 10-4-10-6 эВ в зависимости от входных данных, а ниже уровня шума FP32 расчёт продолжается в FP64. На GaAsBi-64 FP32 даёт ускорение в 2 раза при EDIFF = 10-5 эВ, а связка FP32→FP64 при 10-8 эВ работает в 1,5 раза быстрее чистого FP64.
На H100 и H200, где тензорные ядра FP64 не уступают FP32 по производительности, выигрыш небольшой. А на RTX PRO 6000 решатель Дэвидсона в FP32 работает в 3-7 раз быстрее, весь расчёт - примерно в 2 раза. Смешанная точность включается параметром LDAVIATOR_MIXED_PRECISION (0 означает FP64). Каждый ионный шаг начинается с хранения данных в FP32, пока не будет достигнут DAVIATOR_EDIFF_FP32 или DAVIATOR_SWITCH_TO_FP64_AFTER_STEP; для большинства входных данных подходит 10-4-10-5. В примере заданы EDIFF = 5e-07, LDAVIATOR = True, LDAVIATOR_MIXED_PRECISION = True, DAVIATOR_SWITCH_TO_FP64_AFTER_STEP = -2 и DAVIATOR_EDIFF_FP32 = 5e-05. Нужна лицензия VASP, а Daviator со смешанной точностью будет работать на любом GPU NVIDIA через микросервис ALCHEMI VASP.