Ускорение загрузки данных в GPU с помощью NVIDIA KvikIO и GPUDirect Storage
 Public
- 22 Oct, 2026
NVIDIA Magnum IO GPUDirect Storage (GDS) решает проблему узкого места при перемещении больших наборов данных с накопителя на ускорители, обеспечивая прямой путь передачи, который обходит промежуточное хранение в памяти CPU. По мере экспоненциального роста ИИ-моделей и обучающих датасетов эффективное перемещение данных становится критически важным для обеспечения загрузки GPU. Хотя основным интерфейсом GDS является C API cuFile, Python остается доминирующим языком в современном разработке ИИ. NVIDIA KvikIO закрывает этот разрыв, предоставляя высокоуровневые, идиоматичные интерфейсы на Python и C++ для высокопроизводительного ввода-вывода файлов. Библиотека работает поверх cuFile, предлагая дополнительные возможности управления выполнением запросов ввода-вывода, что позволяет разработчикам управлять путем передачи данных без перехода на низкоуровневый C-код.
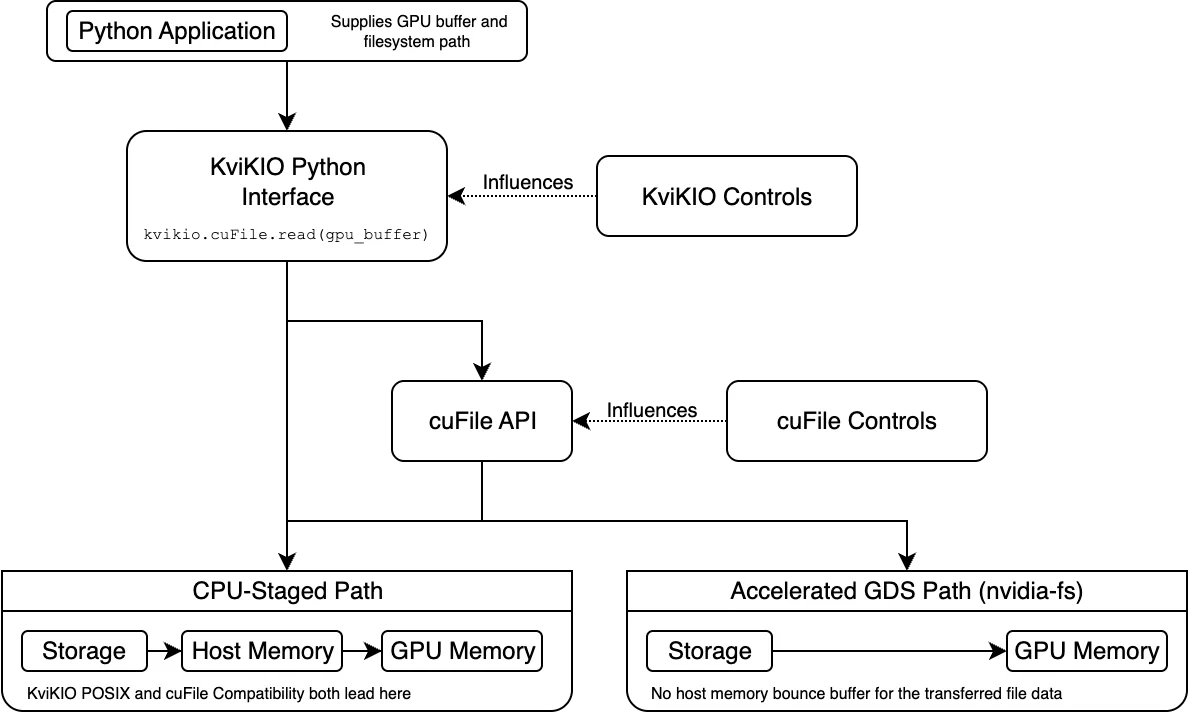
Архитектура включает два отдельных этапа принятия решений о выборе пути передачи данных. Во-первых, KvikIO определяет, отправлять ли запрос через cuFile или использовать собственный путь совместимости POSIX, который использует память хоста как промежуточное звено. На этот выбор влияет настройка compat_mode, которая может принимать значения AUTO, ON или OFF. В режиме AUTO KvikIO пытается использовать cuFile, но переключается на POSIX, если он недоступен. Во-вторых, когда cuFile получает запрос, он решает, использовать ли ускоренный путь GDS или собственный путь совместимости с промежуточным хранением в CPU, исходя из поддержки системой и конфигурации. Таким образом, обращение к API cuFile подтверждает лишь выбор KvikIO, но не гарантирует использование ускоренного пути GDS. Разработчикам необходимо проверять итоговый путь, чтобы обеспечить оптимальную производительность.
Для начала настройте окружение Python и установите сборку KvikIO для CUDA 13 с помощью команды pip install kvikio-cu13, которая включает CuPy в качестве зависимости. Перед выполнением операций ввода-вывода проверьте активную конфигурацию с помощью API по умолчанию KvikIO. Ключевые настройки включают compat_mode, который сообщает о активном режиме, и gds_threshold - минимальный размер запроса, отправляемого в cuFile. На тестовой системе порог составляет 16 КиБ, что означает, что более мелкие чтения выполняются напрямую через путь POSIX KvikIO. Эти настройки можно контролировать с помощью переменных окружения, таких как KVIKIO_COMPAT_MODE и KVIKIO_GDS_THRESHOLD. Кроме того, скрипт gdscheck.py можно использовать для проверки установленных компонентов GDS, поддерживаемых файловых систем и активной конфигурации cuFile на платформе.
Чтобы прочитать данные в память GPU, выделите массив CuPy подходящего размера и используйте контекстный менеджер kvikio.CuFile для выполнения чтения. Например, для чтения файла размером 1 ГиБ необходимо создать буфер CuPy размером 1 ГиБ и передать его в метод read. Чтобы проверить путь передачи данных, включите статистику выполнения cuFile, установив переменную окружения CUFILE_STATS_LEVEL=3 и запустив скрипт в интерактивном режиме. Затем используйте gds_stats для просмотра счетчиков. В выводе по каждому GPU счетчик nvfs отслеживает операции, использующие модуль ядра nvidia-fs (ускоренный путь), а posix - операции, использующие путь совместимости. При настройках по умолчанию чтение 1 ГиБ разделяется на 256 операций по 4 МиБ каждая, все из которых показывают nvfs=256 и posix=0, что подтверждает использование ускоренного пути.
Дополнительный контроль возможен путем независимого изменения настроек KvikIO и cuFile. Установка KVIKIO_COMPAT_MODE=off принуждает KvikIO использовать cuFile, а CUFILE_FORCE_COMPAT_MODE=true заставляет cuFile использовать свой путь совместимости, что приводит к появлению счетчиков posix в статистике. Напротив, KVIKIO_COMPAT_MODE=on полностью обходит cuFile, используя backend KvikIO с промежуточным хранением в CPU. Помимо выбора пути, параметры выполнения в файле cufile.json управляют обработкой запросов. KvikIO разделяет крупные операции на задачи на основе KVIKIO_TASK_SIZE, которые затем отправляются в cuFile. cuFile может дополнительно делить эти запросы на основе своего внутреннего пула потоков и min_io_threshold_size_kb. Например, запрос на 1 ГиБ с размером задачи 4 МиБ приводит к 256 отдельным запросам cuFile, каждый из которых обрабатывается как единое целое.
Если KvikIO отправляет в cuFile один крупный запрос (например, 1 ГиБ), cuFile может разделить его на более мелкие части для параллельной обработки, ограниченной количеством рабочих потоков и max_request_parallelism. В конфигурации с четырьмя рабочими потоками запрос на 1 ГиБ разделяется на четыре части по 256 МиБ. Поскольку целевой буфер не зарегистрирован для DMA-передачи с накопителя, cuFile использует зарегистрированный промежуточный буфер GPU, копируя данные пластами не более 16 МиБ. Настройка min_io_threshold_size_kb влияет на планирование запросов; например, запрос на 16 МиБ может быть разделен на две части по 8 МиБ для соответствия порогу. KvikIO является частью библиотек CUDA-X и использовалась в cuDF, cuCIM и cuPhoton для ускорения загрузки данных в форматах Parquet, ORC и научных изображений. Понимание этих уровней позволяет разработчикам настраивать производительность ввода-вывода под конкретные рабочие нагрузки.